何が起きたか
tohoku-nlpのリポジトリがnanochatにSentencePiece Unigramトークナイザ、日本語事前学習コーパス、SFT・RLデータ、CORE/ChatCOREベンチマーク、Hugging Face Transformers変換器を追加。
なぜ重要か
日本語AIモデルを一から作る開発者が、分離したパイプラインを組まずに単一リポジトリでトークナイザ学習から推論まで完結できる。ただし標準の学習には高性能GPU環境が依然必要。
誰に効くか小規模な日本語AIモデルを一から構築・研究したい開発者や研究者に利点が大きい。同梱のトークナイザ、コーパス、SFT/RLデータ、評価スクリプトを再利用でき、各工程を個別に作らずに済む。
こういう要約が、毎朝あなたのメールに届きます。
nanochat-jpは、Andrej Karpathy氏が2025年10月に事前学習・会話ファインチューニング・推論を単一のコードベースでカバーするものとして公開したnanochatを土台にする。tohoku-nlpのGitHub組織で公開されたフォークはその構造を保ちつつ、言語固有の部分を日本語向けに置き換えた。SentencePiece Unigramトークナイザ、日本語事前学習コーパス、日本語SFT・RLデータ、日本語能力を測るCORE/ChatCOREベンチマークを備え、Hugging Face Transformers形式への変換器も追加している。
リポジトリは同梱のspeedrun.shスクリプトを中心に学習を組み立てており、トークナイザの学習と評価、事前学習、SFT、レポート生成を順に実行する。強化学習も用意されているが標準スクリプトでは任意の工程とされ、事前学習モデルの評価(base_eval.sh)とチャットモデルの評価(chat_eval.sh)は別スクリプトで行う。
コードに加え、開発者はnanochat-jp-v4とv3のチェックポイント、Hugging Face Transformers形式のSFTモデル、学習済みモデル提供用のvLLMプラグインを公開した。ベンチマーク結果では、標準設定のモデルが日本語性能でQwen3.5-0.8Bに匹敵し、v4は5指標中4つでv3を上回ったとしている。Qwen3.5の比較モデルはthinkingを無効にして評価した。日本語AIの仕組みの研究や自作モデルの性能確認に向くプロジェクトだが、標準の学習には高性能GPU環境が必要だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
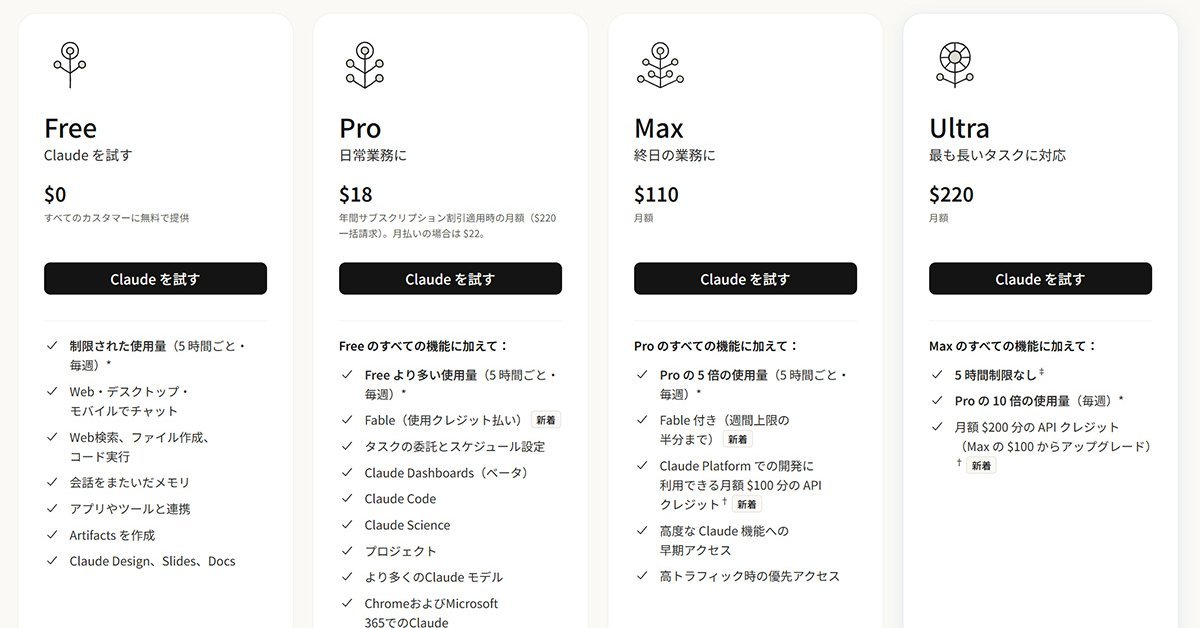
AnthropicはMax 5xをMaxに、Max 20xをUltraに改名し、月額110ドルと220ドルは据え置いた
Chrome 157の安定版がリリースされ、Android版ChromeにLanguage Detector APIが追加された
GoogleはK-12アカウントでGemini、Gemini Notebook、Gemini in Classroom、Google Searchを管理者が有効化するまで既定でオフにすると発表した
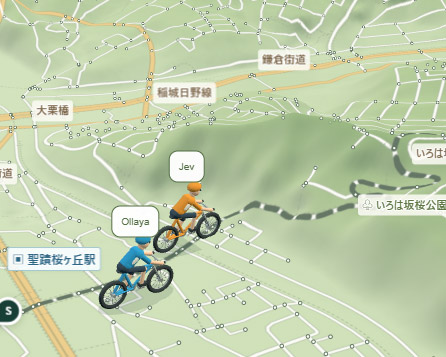
Nvidia DGX Spark上の自転車ルート判断テストで、TypeSafe AIのJevがwinnowモデルを動かすOllayaを破り1位
Anthropicは、AIの出力をその生成元の特定モデルに結びつける暗号学的証明を生成するオープンソースシステムFlashProveの研究成果、コード、技術仕様をGitHubで公開した
DellとMicrosoftは提携を拡大し、Dell Automation PlatformとPrivate CloudをAzure Local、Azure Arc、SQL Serverと統合