何が起きたか
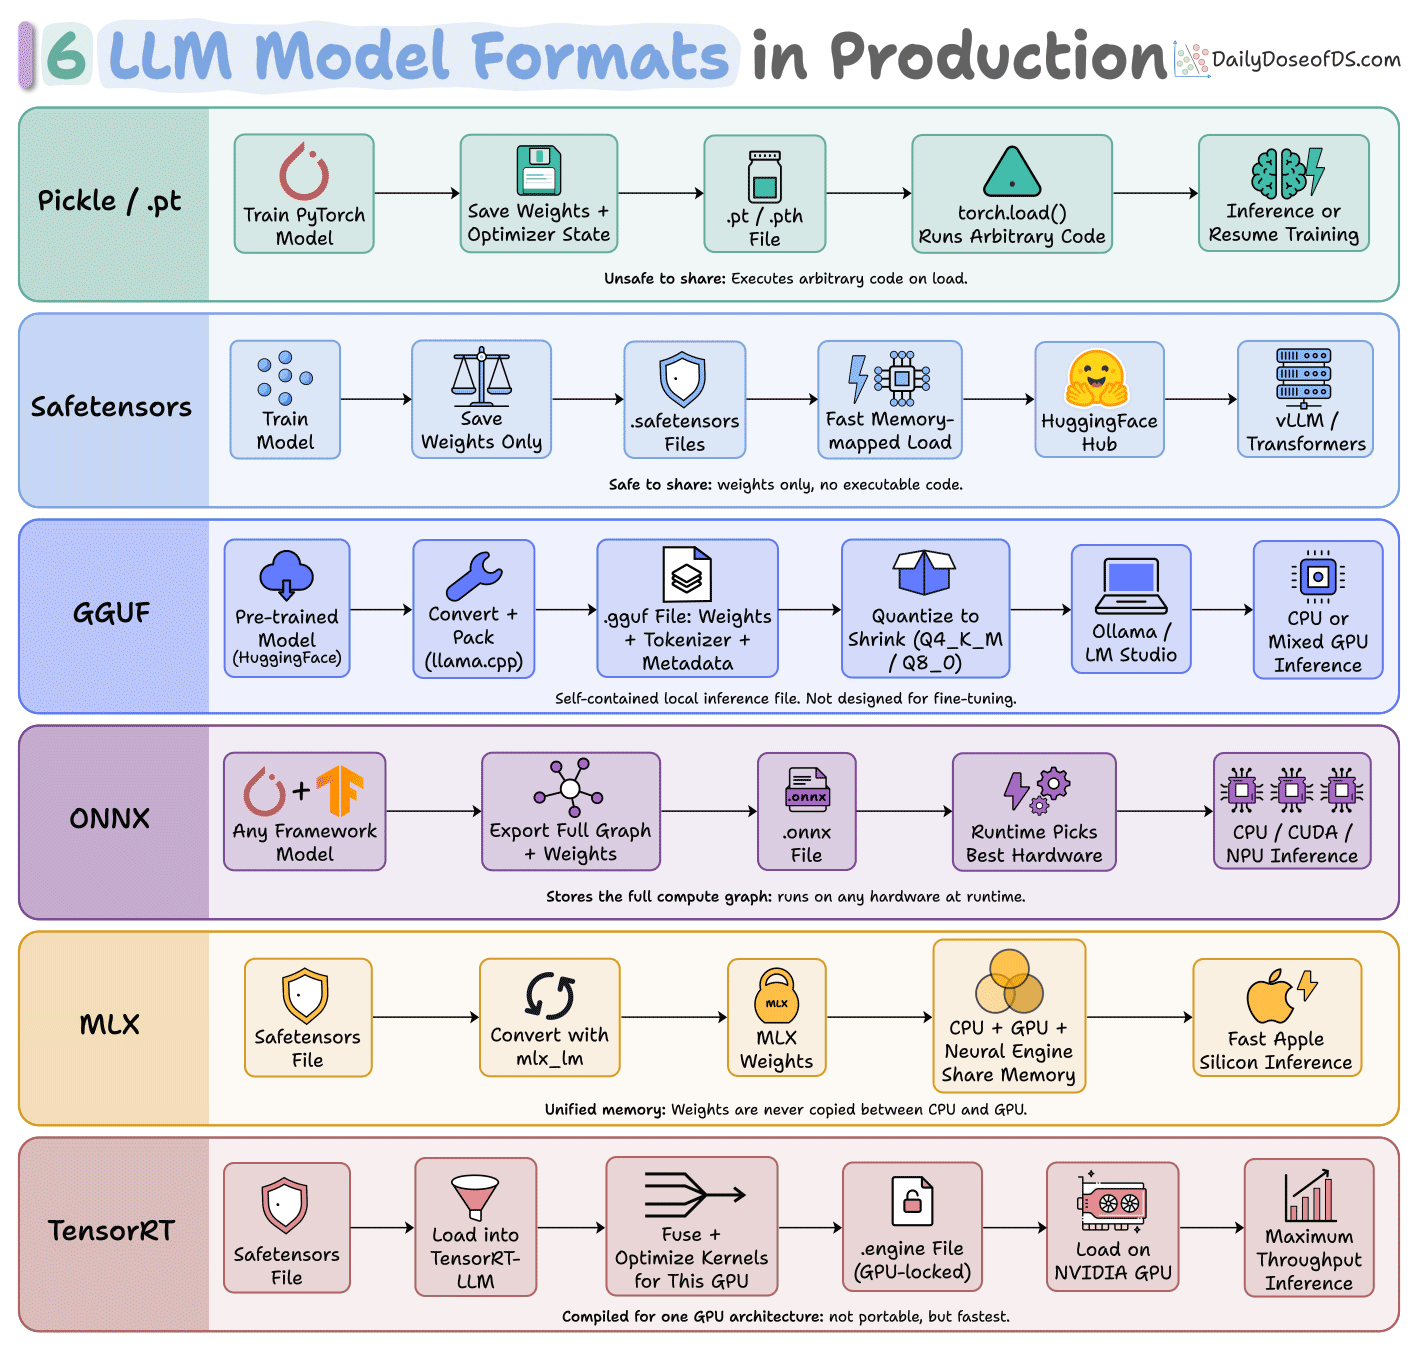
本番環境向けLLMデプロイ6形式(Pickle、safetensors、GGUF、ONNX、MLX、TensorRT)の技術的解説。推論速度とハードウェア互換性のトレードオフがそれぞれ異なる。PickleとsafetensorsはいかなるPython環境でも動作。GGUFはCPU専用マシン向けに重みとトークナイザーをバンドル。ONNXはモデルをフレームワーク間で切り替え可能。MLXはAppleシリコンに最適化。TensorRTは特定のNVIDIA GPUにコンパイルして最大速度を実現する。
なぜ重要か
モデルを高速化するには、ハードウェア固有の選択をファイルに組み込む必要があり、1つのモデルを対応させるチップやランタイムごとに再構築しなければならない。チームは速度と互換性のトレードオフにおいて、どのレベルまで下るかを決断する必要があり、推論レイテンシを削減するか、本番環境で実行できるハードウェアの種類を広げるかを天秤にかけることになる。
注目点
記事は、レイテンシ予算が許す限り、デプロイ形式を速度と互換性チャートの高い位置に保つことの重要性を強調している。より高速な実行へのあらゆる一歩は、対応できるハードウェアを狭めていく。LLMをデプロイするチームは、応答時間の最小化と可搬性の最大化との間で絶えず折衝を迫られる。
こういう要約が、毎朝あなたのメールに届きます。
記事はLLMデプロイの根本的な制約である速度と可搬性のトレードオフを枠組みとしている。モデルがハードウェア固有の最適化を通じて高速化するにつれ、可搬性は低下する。これが大規模AI企業が同じモデルの複数バージョンを保有する理由を説明し、それは選択ではなく実際の必要性である。6つの形式はスペクトラムを形成し、最も安全なデフォルトはチャートの高位置(互換性重視)にあり、レイテンシ予算がそれを要求するときだけ下へ進む。
この分類からは、異なる環境に異なる形式が存在する理由も見える。GGUFとOllamaはPythonやMLフレームワークが利用できない環境(エッジデバイス、MLインフラなしのサーバー)へのデプロイを可能にする。ONNXは橋渡し役で、あるフレームワークで学習されたモデルを別のフレームワークで実行できる。MLXとTensorRTはその対極にあり、Appleの統一メモリアーキテクチャとNVIDIA特定のGPU命令セットに完全にコミットして最大速度を実現する。チームが形式を選択することは、本質的にはどのハードウェア制約を受け入れるかを選択していることだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

OpenAIは10月15日、Rosalind Academic Planを発表した

Qiita記事がLLMアプリ向け自動レッドチーミング手法GCG・PAIR・TAPを実LLMなしの模擬実装で比較した

Liquid AIは2026年10月15日、オープンウェイトの改良版意思決定モデルd1-ultraを公開した

CircliaがTASTE SIGNALの実証実験を開始した

フランス数学会会長イザベル・ガラガー主催のウェビナーで、フィールズ賞受賞者のユーゴ・デュミニル=コパンは、OpenAIが350の主要未解決問題の解答を一夜で公開したと述べた

