何が起きたか
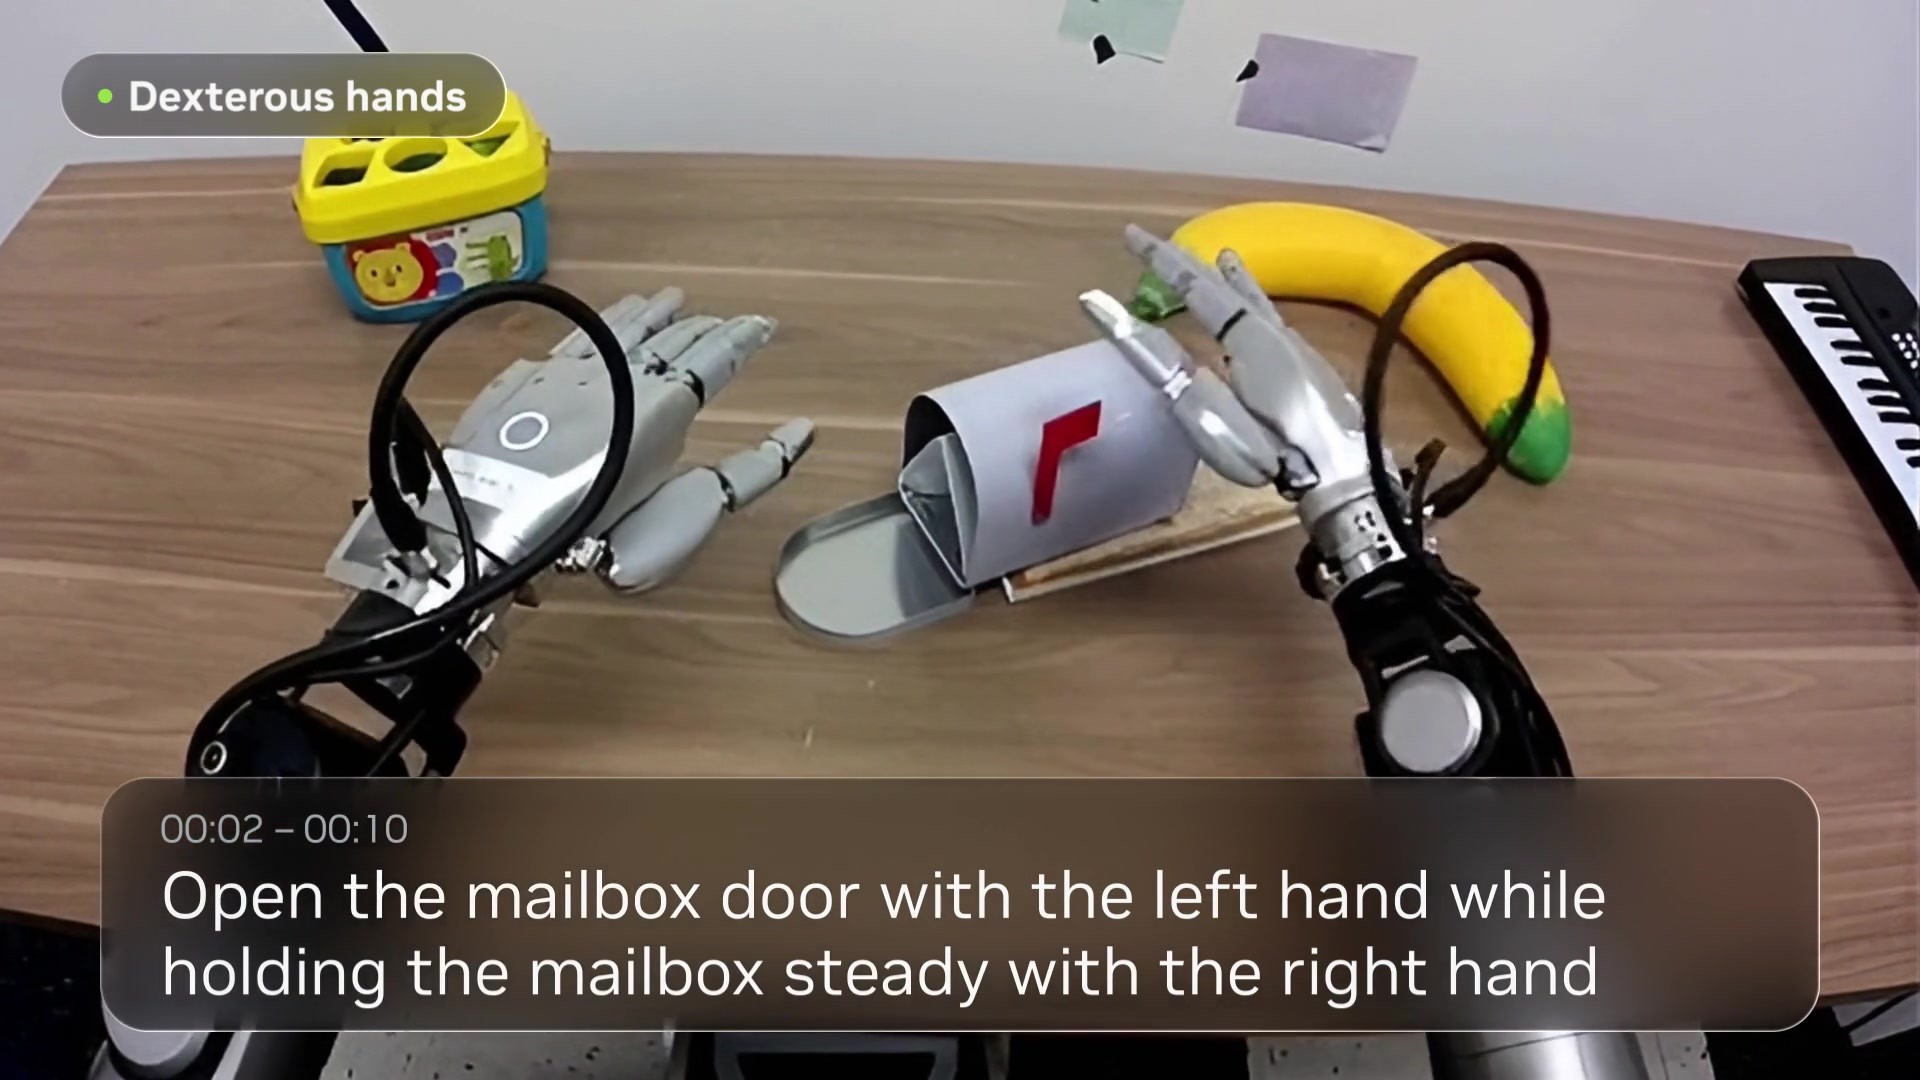
Nvidiaが、3種類のラベルを網羅する、微調整済みQwen3.5モデル3基構成のデータエンジンFloraをオープンソース化した。動画1時間のラベリングコストは約72セントである。
なぜ重要か
この予想価格なら、ロボットモデルが学習する大量の動画の注釈コストが大幅に下がる。Nvidiaによれば、FloraはGR00Tモデルの訓練中にすでに稼働し、1日最大20万時間の動画を注釈付けしている。
誰に効くかロボット基盤モデルを構築するロボティクス研究者やAIチームが直接の対象だ。Floraを使えば自社の動画データセットをはるかに安価にラベリングできるが、コストの数字は本番実測ではなく予測値である。
こういう要約が、毎朝あなたのメールに届きます。
NvidiaはFloraを、Scale AIのPhysical AI Data Engineなど商用ラベリングサービスに対するオープンな代替手段と位置づける。狙うギャップは構造的なものだ。既存ツールの多くはロボット訓練に必要な3種類のラベルのうち1種類しか提供せず、GPT-6 Astraのような汎用モデルは複数種類を生成できるものの、対象となる動画量にスケールしないコストがかかる。Floraは作業を特化モデルに分割し、9Bモデルが動画を行動にセグメント化し、27Bモデル2基が記述と報酬スコアリングを担う。
品質面の評価はまちまちだ。Floraの最も明確な優位性は時間的ローカライゼーションにある。RoboRewardBenchではエラー率がAstraより27.8パーセント低く、報酬モデルはエピソード内の失敗ステップの53.3パーセントを検出する。競合他社は11.7パーセントを超えず、Astraはまったく検出できない。代償として、正常なステップの約11パーセントを誤ってエラーと判定する。ある例では、Floraは参照行動37件のうち34件を特定したのに対し、Astraは4件だった。ただしFloraは長い行動を過剰に分割したり、誤って記述したりすることがある。
Floraは、ハードウェアや訓練データからシミュレーション、モデルまでロボティクスのバリューチェーンをカバーし、開発者を自社のハードウェアエコシステムにつなぎ留めようとするNvidiaの広範な戦略に沿うものだ。また、GTCでNvidiaが示した自動データパイプラインにラベルと報酬のシグナルを加える。GoogleのGemini 4 Argonもロボット訓練の同様の領域を狙っており、訓練データツールをめぐる競争は広がりつつある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎朝届ける法人プランもあります → 詳しく見る
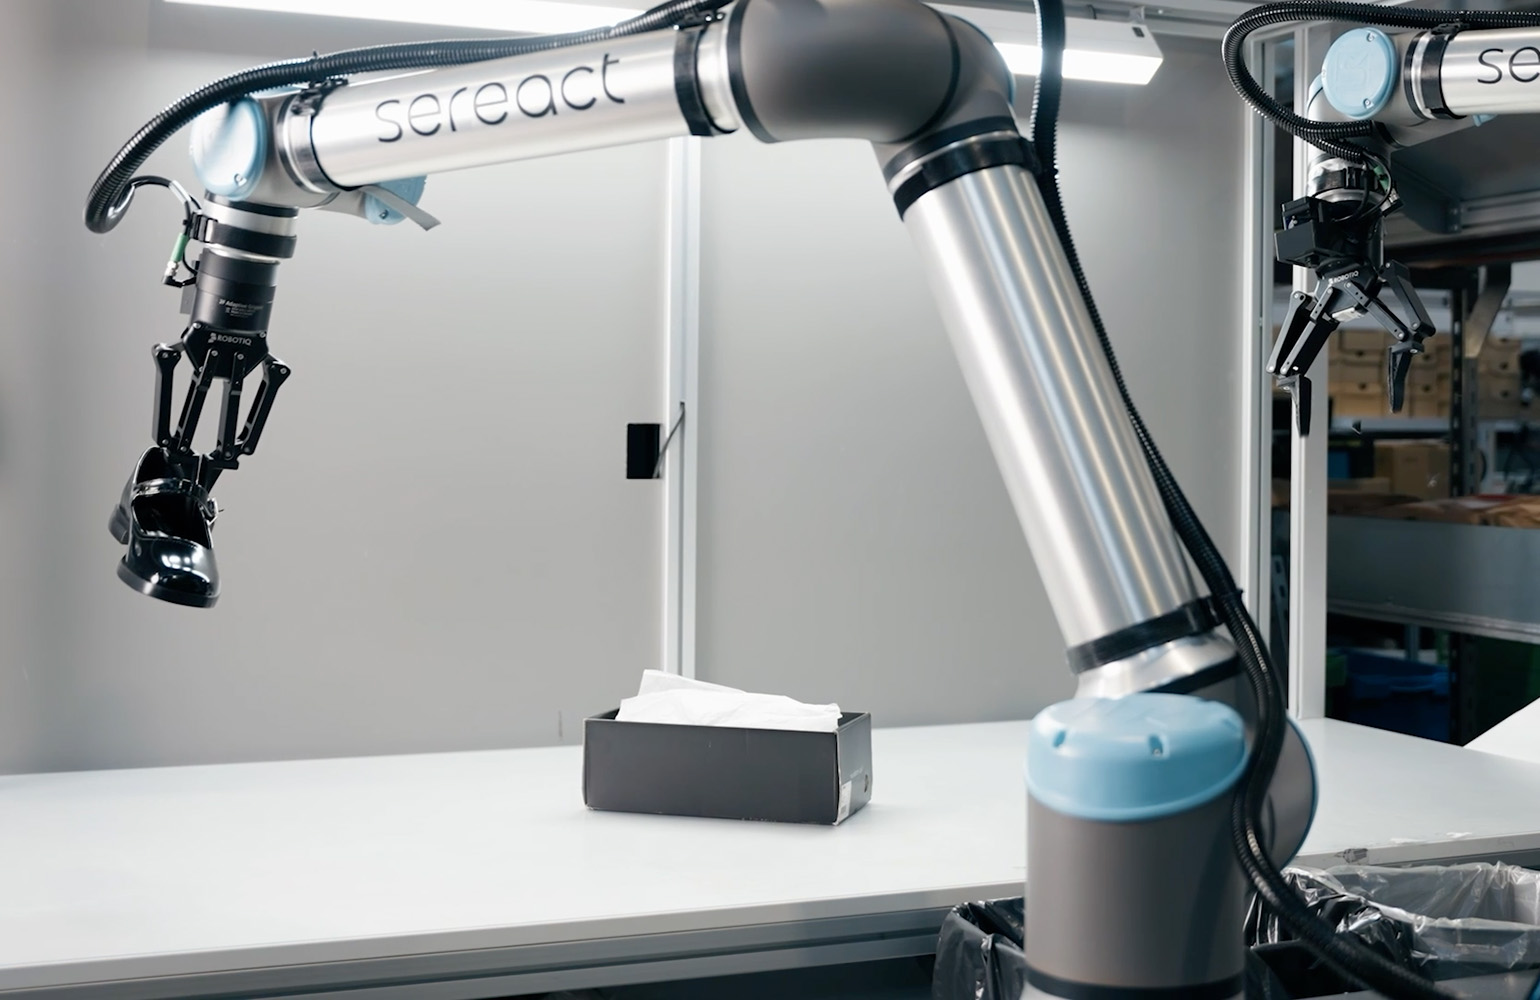
テラダイン・ロボティクスはSereactと提携し、ユニバーサルロボットのアームでSereactのCortex物理AIプラットフォームを稼働させる
Anthropicは2026年10月1日に「Claude-shaped science」を公開し、Matthew Schwartz氏のツールキットBootLoopsが数週間で30の積分を処理したと説明した
Authentic Brands GroupがAnthropicを提訴
Anthropic共同創業者のJack Clark氏が、再帰的自己改良が早ければ2027年に可能になるとの見方を示した
Anthropicは、必要な時にコンテキストを読み込む単一エージェントが、品質・コスト・遅延でマルチエージェント構成を上回ることが多いと発表
RipplingのCEO Parker Conrad氏によると、コーディング作業でOpenAIのシェアは16%から52%に上昇し、Anthropicは57%から18%に低下した