何が起きたか
著者はFFmpegとopenai-whisperを導入し、mediumモデルをmeeting.m4aに日本語指定で実行、.txt、.srt、.tsv、.jsonを得た。
なぜ重要か
Whisperは発言者を分離できないため文字起こしは下書きであり、固有名詞や担当者、期限は手作業で直す必要がある。自動話者ラベルより安全とみられている。
こういう要約が、毎朝あなたのメールに届きます。
この手順は完全自動化ではなく、実用的な役割分担を軸に組み立てられている。Whisperがタイムスタンプ付きの文字起こしを生成し、決定事項、議論の要約、担当者と期限を記すアクションアイテムの各欄を備えた著者の議事録テンプレートが、人の作業が始まる箇所を示す。著者は、社内用語や略語、カタカナ語は特に誤りやすく、会議資料や出席者リストと照合して確認すべきだと強調している。
精度については、著者自身の検証で、ファイル変換よりも録音条件の方が重要だと分かった。FFmpegでモノラル16kHzに変換しても結果は安定して改善せず、マイクを話者に近づけ、同時発話を減らす方が効果的だった。会議の文脈を説明する初期プロンプトは技術用語の表記を安定させられるが、特定の単語が認識される保証はない。
ローカル環境での実行にはデータ管理の観点もある。機密性の高い録音ではWhisperを自分のPCで動かすのが有効な選択肢だと示す一方、ファイルや文字起こしの保存先、バックアップ、アクセス権限は別途確認が必要で、録音の削除は社内やチームの規則に従うべきだとした。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
11月10日のNVIDIAのAgentic AI Day Japan 2026で、JAISTの今井翔太氏は、競争の激しい分野はフロンティアモデル、非競争的なタスクは主にオープンモデルになると予測した
Hugging FaceのIrene Solaiman氏はポッドキャスト「Equity」で、オープンAIプラットフォームは攻撃者を引き寄せると述べ、10月のOpenCodeへの攻撃と夏のOpenAIのエージェント群のHu…
ai&がMeta初のオープンウェイトモデルMuse Spark Open(meta/muse-spark-open)をai& Inferenceで提供開始
NVIDIAは日本の大手金融機関の協力を得て構築したNemotron Personas Finance JapanとNemotron PII JapanをHugging Faceで公開した
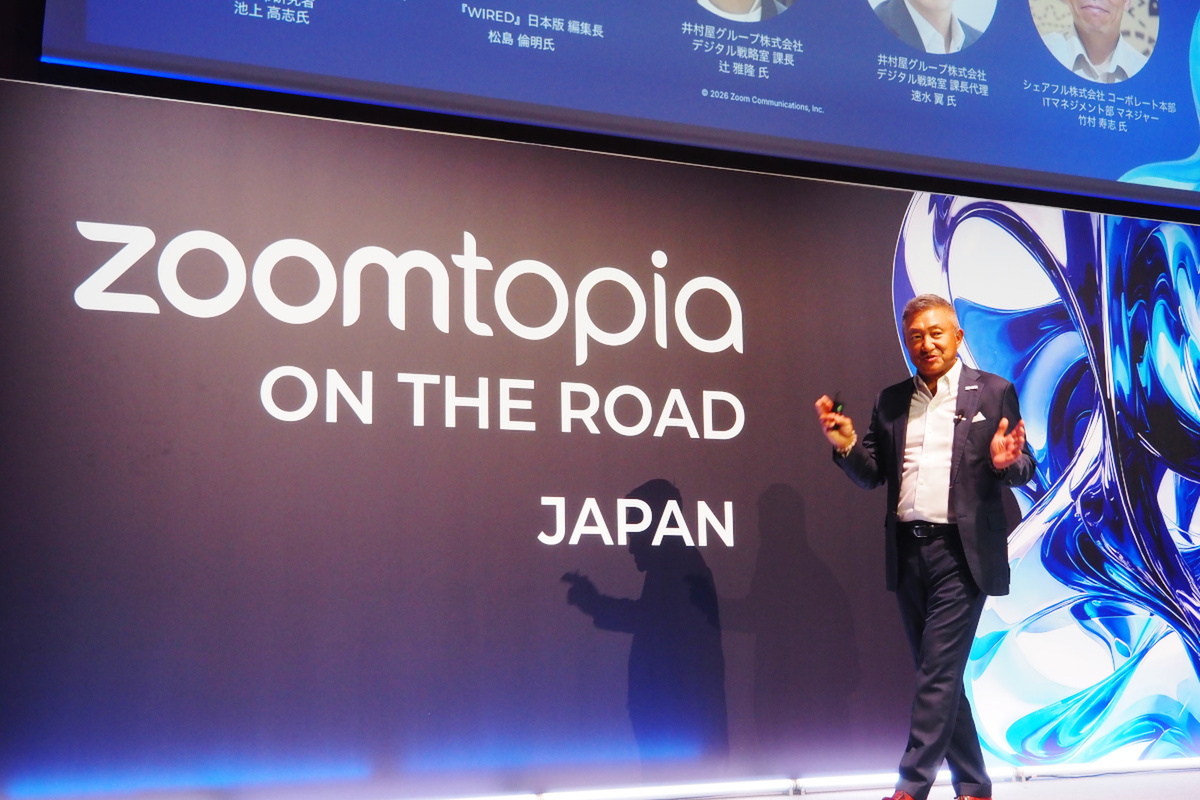
Zoomtopia ON THE ROAD 2026 JAPANでCTOのXuedong Huang氏は、2026年9月のHuggingFace音声文字起こしベンチマークでZoomの「連合AI」が日本語含む9言語で1位と…
NVIDIAは10万時間の一人称視点データで学習したオープンワールド行動モデル「GR00T 2」を発表した