何が起きたか
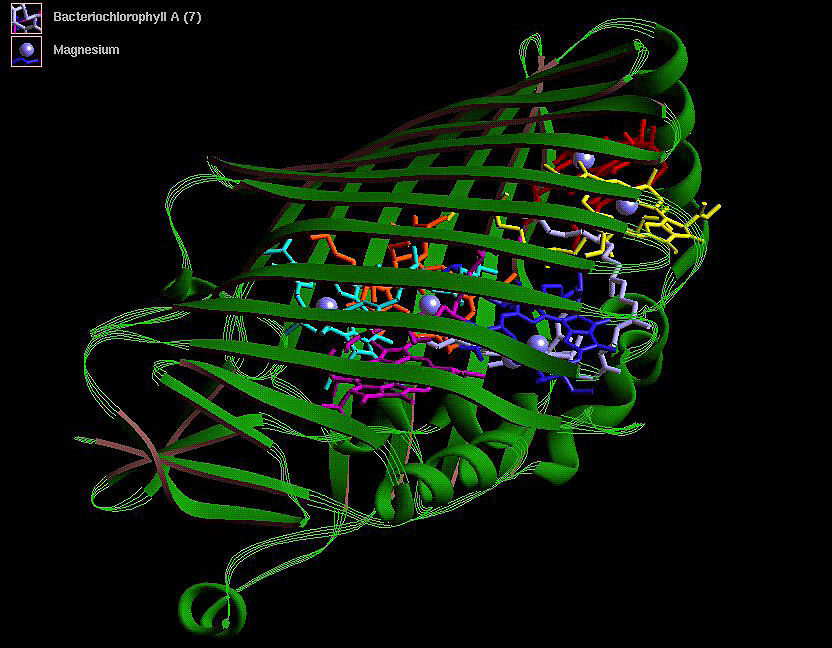
中国の研究者らがPinalを公開した。T2structとSAProt-Tの2モジュールで平易な指示をタンパク質配列に変換し、8億組のキーワードとタンパク質のデータで学習した。
なぜ重要か
アミノ酸の位置を指定せずとも欲しい機能を日常言語で説明できるため、専門家以外にもタンパク質設計の間口が広がる可能性がある。ただし候補の選別や検証には依然として実験室が必要だ。
誰に効くか日常英語で問いを表現できても、専門ツールを設定するバイオインフォマティクスの知識がない実験生物学者にとって、こうしたインターフェースは有用になり得る。ただし設計の選別と検証には実験機器と訓練を受けたスタッフが依然として必要だ。
こういう要約が、毎朝あなたのメールに届きます。
タンパク質設計ツールは一般に、AIが構造を組み立てる前に、どのアミノ酸を3次元空間のどこに置くかといった詳細な制約をユーザーが指定する必要があった。Pinalは出発点を変え、日常言語で機能を説明できるようにした。T2structが指示を構造の設計図に変換し、SAProt-Tがアミノ酸配列を組み立てる2段階の仕組みだ。学習には3つのデータベースのタンパク質配列とAlphaFoldが予測した構造の組み合わせを使い、1つのデータベースだけで8億組のキーワードとタンパク質のペアを含んでいた。試験での低い的中率は意図的な絞り込みを反映している。研究チームは既知の蛍光タンパク質に似すぎる候補を除外したため、機能する可能性が高い設計の多くが試験前に除かれた。別の関連発表として、Hugging Face、中関村学院、ナポリ大学フェデリコ2世は、ローカル環境で動かせるオープンウェイトのDNAモデルCarbon Xを発表した。Carbon XはQwen3-14BをベースにDNAで再学習し、さらに微調整を施してDNAと自然言語の両方の指示を扱えるようにした。チームはその挙動を記した論文をまだ公開していないが、内部での性能はGPT-6.1 Solのような大規模商用モデルに匹敵するとされ、位置特異的な精度やハルシネーションへの注意も付されている。どちらのツールも、自然言語のインターフェースが生物学に浸透しつつあることを示すが、実験室での検証の必要性が制約として残る。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Googleは、テキスト記述からインタラクティブな3D世界を構築するAIモデルGenie 4を予告した
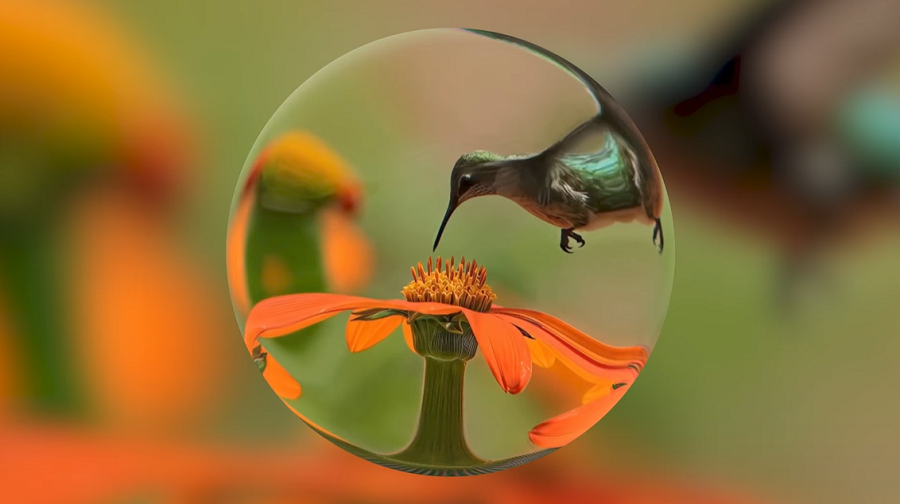
対象はメンバー1000人以上の「Discoverable Servers」で現在6万以上
Anthropicは月曜日にS-1を公開し、約2兆ドルの評価額を目標とし、第3四半期売上168億ドル、年換算ランレート670億ドルを開示した
OpenAIは米国太平洋時間10月26日、GPT-6.1 Terraを公開した
OpenAIは2026年10月24日、Day 19としてCodex CLI 0.164.0を公開し、CodexとChatGPT Workで推論レベル切り替え時にキャッシュが無効化されないよう変更した
OpenAIの28日間連続リリース企画の13日目、Tibo SottiauxがCodexとChatGPT Workの利用枠リセットを発表し、約5時間後に「完了」と投稿した