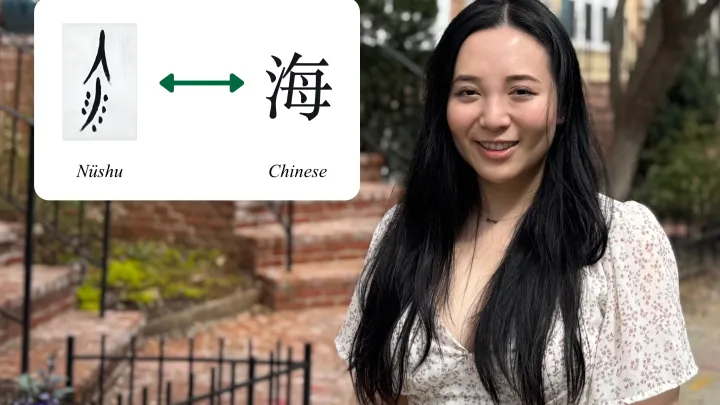
何が起きたか
DartmouthのIvory Yang氏らがNüshuRescueを構築し、35組の中国語・女書の文対でGPT-4 Turboを訓練、未見のテスト表現を女書に翻訳した。
なぜ重要か
専門家が検証した500組の女書・中国語データセットは初の試みで、人手注釈を最小化する枠組みはCherokeeなどへの応用も可能だ。
注目点
Vosoughi氏は支配的文化のバイアス混入を警告し、真正性は母語話者と言語学者の協働にかかると指摘。Yang氏は次にハンカチや扇の女書向け画像認識モデルを目指す。
誰に効くかこれは危機言語を記録する言語学者やコミュニティ関係者に最も大きな影響を与える。何年もの手作業注釈の代わりに疎なデータセットを使えるようになるからだ。また、Navajoの文を誤判定したGoogleのLangIDのようなツールを評価する研究者にとっても重要である。
こういう要約が、毎朝あなたのメールに届きます。
女書は4世紀前、湖南のヤオ族の女性たちが秘密文字として生み出したが、女性が正式な教育を受ける機会を得た1900年代に使用が減り、多くの文書が失われたり破壊されたりした。今世紀に入ってから、中国はこの文字を絶滅から救う取り組みを続けてきた。Yang氏の研究はその長い流れの中に位置する。彼女は子供の頃に祖母から女書のいくつかの単語を学び、今はAIをこの問題に応用している。プロジェクトは、専門家が検証した最も包括的なスキャン文字とその中国語訳の集成である『中国女書大全』から始まった。そこからチームは計算言語学の訓練を受けた注釈者と協力し、新たにマッピングされた単語を含む500組のデジタル化文対を作成した。
Dartmouthの研究は、既存の言語技術が過小代表言語をどう扱うかという広範な検証と並んでいる。Association for Computational LinguisticsのNations of the Americas Chapter会議で発表予定のYang氏の最近の論文は、GoogleのLangIDがほとんどの先住民族言語をサポートしておらず、Navajoの文を無関係な言語と誤判定することを発見した。別途、言語学教授のRolando Coto Solano氏は、何百時間もの録音の文字起こしを終える前に自分は死ぬかもしれないという同僚の発言に動機づけられ、Cook Islands Māori、Bribri、Cabécarの自動音声認識モデルを構築した。
Vosoughi氏は、これらのモデルが支配的文化のバイアスを帯び、文化的アイデンティティを歪めたり単純化しすぎたりする可能性があると警告しており、その成否は協働にかかっている。同氏は、言語の真正性には母語話者と言語学者の積極的な参加が不可欠であり、AIとコミュニティの専門知識の両方が基本だと主張する。NüshuRescueの低データ手法が他の低資源言語に拡張できるかどうかは、モデル単体ではなく、コミュニティがその取り組みをどれだけ密接に形作るかにかかっているかもしれない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Innovation BASE 北海道が2026年11月4日発表で、AI:Promoの画像編集にOpenAIのGPT-Image-2.6 Sunburstを採用し、範囲を囲む・四角で囲む・印を付けるマークアップ編集を追加…
Softcreateの山口氏がMicrosoft 365 Copilot向けに、日報プロンプトの作成、出力確認、スケジュール済みプロンプトへの登録、スケジュール管理という4段階のガイドを公開した
開発者がmellowをリリース
kensaurusがMITライセンスで162個のMarkdownスキルファイル集kensaurus/skillsを公開
RevolutのDavid Abitbol氏によると、OpenAIのCodexでコーディング時間が30〜60%削減され、GPT‑5.5搭載のFinCrimeエージェントがスクリーニングや調査を自動実行している
Growill合同会社がGrowill Compassの先行導入企業5社の募集を開始


