
何が起きたか
Qwenは2026年8月27日、Qwen3.8-Flash-Nextを公開し、Qwen4.x向けアーキテクチャのプレビューと位置付けた。
なぜ重要か
既存構造の再利用ではなく独自改良を重ねており、蒸留頼みでない独自技術を示す設計だ。
注目点
Qwen4.x登場前にllama.cppが新注意機構を完全対応するかが焦点。sparse flash attentionのPR #28349を注視。
何が起きたか
Qwenは2026年8月27日、Qwen3.8-Flash-Nextを公開し、Qwen4.x向けアーキテクチャのプレビューと位置付けた。
なぜ重要か
既存構造の再利用ではなく独自改良を重ねており、蒸留頼みでない独自技術を示す設計だ。
注目点
Qwen4.x登場前にllama.cppが新注意機構を完全対応するかが焦点。sparse flash attentionのPR #28349を注視。
誰に効くか影響を最も直接受けるのは、消費者向けGPUでモデルを動かすローカルLLM愛好家や開発者だ。このアーキテクチャは大規模モデルのメモリ使用量削減と出力高速化を狙っている。
こういう要約が、毎朝あなたのメールに届きます。
Qwen3.8-Flash-Nextは2026年8月26日に告知され翌日届いた、突然の先行リリースだった。注目を集めたのはQwen4.x向けアーキテクチャとの明言された関連で、Qwenチームが本リリース前に次世代設計を公然と試す意欲を示している。
このモデルは従来のQwen設計から2点で大きく外れる。Qwen Sparse Attentionは単一トークンではなく4トークンのマイクロブロックを処理し、長文脈の計算量削減を狙う。N-gram Embeddingは静的情報をグラフィックスメモリではなくメインメモリに置き、大規模モデルのメモリ負荷を下げうる。
著者の検証は、この手法が実用で報われることを示唆する。非常に大きなモデルでも、文脈のメモリ使用量はより小型のQwenモデルが使った量を大きく下回った。Qwen4.x登場までに支援ソフトウェア生態系が追いつくかは注目に値する。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NVIDIAは2026年9月21日、「AIセキュリティは工学の問題――エージェントスタックの全層で解決する方法」と題したブログ記事を公開し、判断を誤ったエージェントでも行動を止められる理由を説明した

検証では、Haiku 5.5はmedium設定で定型文書ならSonnet 5.5に近いスコアを約1/17のコストで出したが、英語メール課題では6.3点まで落ちた

Black Forest Labsが2026年10月15日、FLUX 3 Image Kleinをオープンウェイトとして公開した

Metaは8160億パラメーターのオープンウェイトモデルMuse Spark Openを公開
PrismMLは2026年10月15日、Ternary Bonsai 2の2B・4B・9Bを公開した
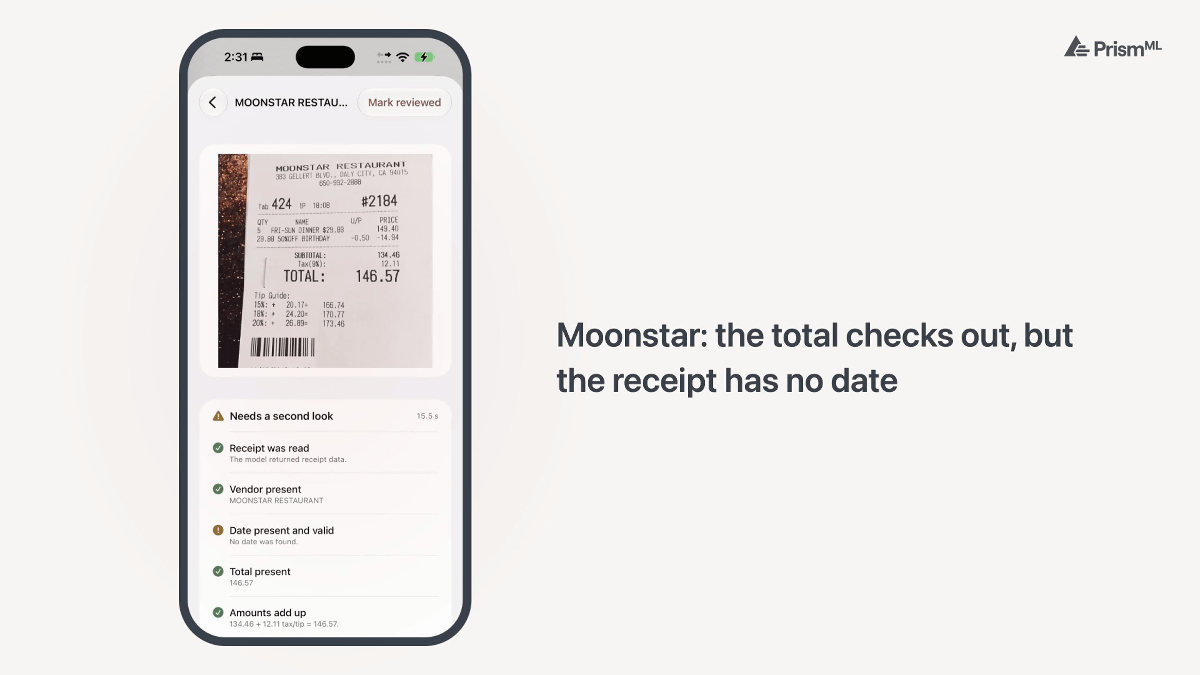
EC自動化工房がZenn記事で商品マスタ生成前クレンジング手順を示した

