何が起きたか
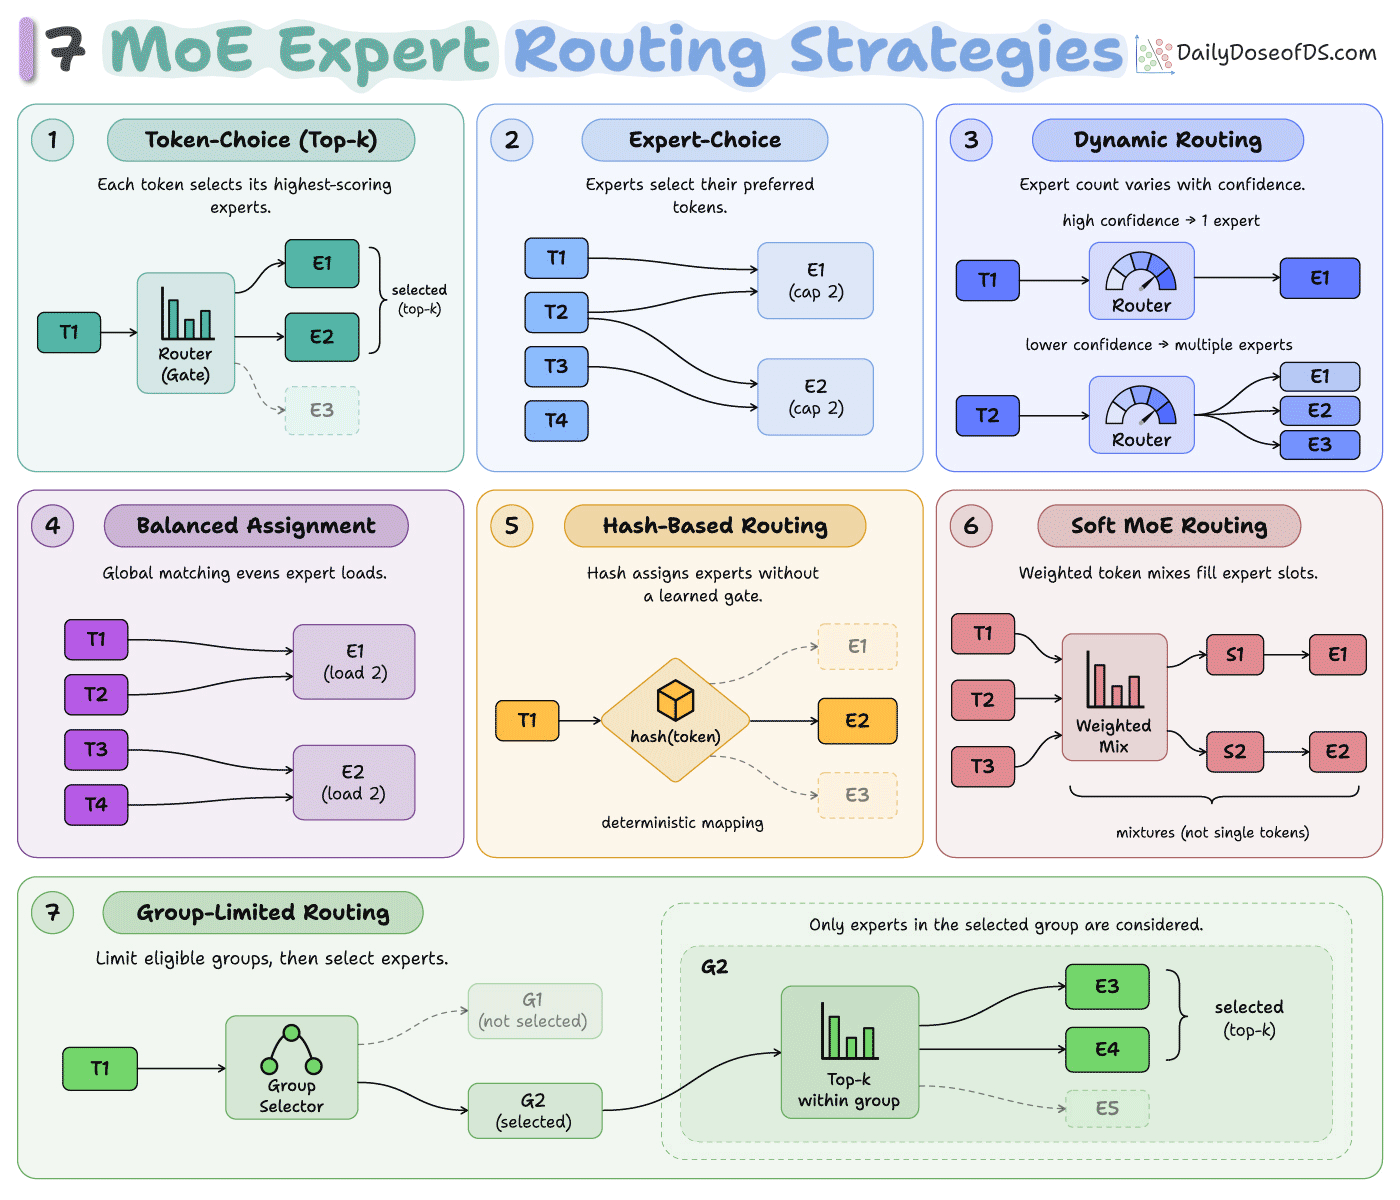
MoEモデルがトークンをエキスパートに割り当てる7方式を解説。DeepSeek-V3のノード制限ルーティングは各トークンを最大4ノードに送り、Soft MoEはトークンの重み付き混合を用いる。
なぜ重要か
全トークンを最高スコアのエキスパートに送ると一部が過負荷となり割り当てが破棄されうるため、ルーティング設計がMoEの計算削減効果を決める。
こういう要約が、毎朝あなたのメールに届きます。
MoEが約束する計算削減が静かに失われうる場所としてルーティングを位置づけている。全トークンを最高スコアのエキスパートに送るのは効率的に見えるが、多くのトークンが同じエキスパートを好むと、そのエキスパートは過負荷になり他は遊休する。固定容量と破棄ルールがあれば一部の割り当ては破棄され、偏った負荷とGPU間の通信オーバーヘッドが削減効果を損なう。
7つの設計はそれぞれこのトレードオフに異なる形で対処する。Expert Choiceは選択を逆転させ、各エキスパートが固定容量内で最高スコアのトークンを選ぶが、エキスパートの負荷が均等でもトークンごとの計算量は不均等になりうる。動的ルーティングは稼働エキスパート数を変動させ、BASE Layersのようなグローバルマッチングはバッチを均衡させるため一部トークンが第一希望のエキスパートに届かないことを許容する。ハッシュ化は柔軟性と引き換えに学習済みゲートを完全に排除し、Soft MoEはエキスパートがトークン表現の重み付き混合を処理し、ハードウェアに沿ったグルーピングはDeepSeek-V3のノード制限ルーティングのようにトークンが移動できる範囲を狭める。記事はこれらがルーティング設計であり、 servingエンジンの交換可能な設定ではないこと、また一部は学習や視覚研究由来で自己回帰生成には注意が必要だと警告している。
実践上の軸は計測だ。トークンを均等に分散しても低遅延は保証されない。エキスパートのバッチが小さく、デバイス間のトークン移動に時間がかかるためだ。プロファイリングではルーティング、トークン移動、エキスパート計算、結合を分離し、最も遅い段階を見える化すべきであり、記事はその経路の構築とベンチマークのためのGitHub上の10週間の推論エンジニアリングロードマップを挙げている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Vals AIがThinking MachinesのInkling 2 Smallの思考ログを13ベンチマーク・2,655回分調査し、50回で計316件の暴言を確認
Anthropic InstituteのAndy HallがMETRのMALTデータセットを使いGPT-5やGPT-6 Astra、Gemini 3.8 Flashなど5モデルで監査を再現したところ、誤検知率5%の条件で…
Anthropicの11月6日の投稿はエージェント記憶を3層に分類
Google DeepMindは2026年11月6日、AIモデルが1024-bit RSAの電子署名偽造を可能にする欠陥とmodulusのバッチ因数分解コストを下げる新アルゴリズムを発見したと発表した
Metaが9月に中小企業向けAIエージェントMuseを投入し、AnthropicとOpenAIも事業者向けツールを提供、Googleも既存ツールに同機能を組み込んでいる

Vergeの試用でNYT CookingのAIが「生姜風味のワンポット鶏肉とご飯」を書き換え夫も認めたが、焼き菓子でバター6大さじを指示し元の3/4カップでなかった