何が起きたか
GoogleのEmbeddingGemmaチームが、テキスト・画像・音声・動画とその組み合わせを単一の768次元埋め込み空間に写像する744Mパラメータモデルを公開。
なぜ重要か
論文はこの統合設計が新たなパレートフロンティアを築き、専用モデルや2〜12倍大きいモデルを上回ると主張。事実なら、マルチモーダル検索・検索システム構築の簡素化につながる。
注目点
マルチモーダル構成全体はGoogle Pixel 11 Pro上で567 MB、テキスト専用量子化版は191 MBで動作する。
誰に効くか検索・検索システムを構築する企業のMLチームは、別途ASRパイプラインを用意せずにテキスト・画像・音声を扱える単一の埋め込みモデルの恩恵を受けられる可能性がある。モバイル端末に導入する開発者はメモリ使用量を注視している。
こういう要約が、毎朝あなたのメールに届きます。
今回の公開はオープンウェイトの発表が相次ぐ週に行われ、従来は専用モデルが必要だったモダリティの統合を狙うGoogleの一手と位置づけられる。パラメータ配分は意図的に分けられており、271Mのテキストバックボーン、167Mの視覚エンコーダ、305Mの音声エンコーダが共有の768次元出力を担う。著者によれば、これによりモダリティエンコーダの選択的読み込みが可能になる。つまりテキスト専用アプリは読み込み時に重い視覚・音声の塔を完全に省け、オンデバイスのフットプリントを小さく保てる。
設計の価値を最も鮮明に示すのはネイティブ音声のアブレーションだ。ネイティブ音声検索のMRR@10スコア69.54は、Google自身の従来のEG1 ASR+テキストパイプラインの50.95を上回る。音声をテキストに変換せず直接扱う方が検索品質を高められる可能性を示し、言語をまたぐと差は67.68対41.87まで広がる。著者は量子化後も品質が保たれるとも述べており、MTEB(English)はint4 Q4_Cで68.49とわずかに上昇する。これらの利点がより広いベンチマーク群でも維持されるかは、オープンウェイトコミュニティによる検証が進むにつれ明らかになるだろう。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
IteraのLLMOチェキが「AI質問の提案」を開始

サカナクション山口一郎が10月27日のYouTube生配信で、パスタに混ざったカメムシの句をChatGPTに頼むと、「うんうん、聞いてるよ」と相づちだけを返し、「こんな壊れ方するの?
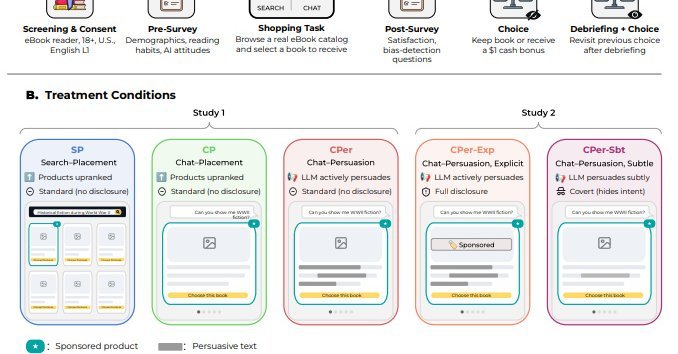
プリンストン大学の研究で、参加者2,012人と約5,500冊を使い、広告商品の選択率は検索結果経由22.4%、中立のチャット配置26.8%、AIに秘密裏に説得を指示すると61.2%だった
Palantirの防衛部門責任者Mike Gallagher氏は水曜日、AI開発における台湾の役割が増大し、習近平国家主席が北京の台湾構想を実行に移す必要が生じかねないと述べた
Project Tadoriの「ワイカメ」が10月29日、無料の対話型トップページを公開
NTT TechnoCrossは12月からForeSight Voice MiningにAIナビゲーションを追加