何が起きたか
MiniMax Group Inc.が6月のM3モデルの改良版M3.1 Flashを公開。エージェント作業のコストが70%減り、推論は3倍近く速くなると主張。パラメータ数は4280億。
なぜ重要か
AIエージェントは1件の作業に何十回ものモデル呼び出しが必要な場合が多く、作業あたり7割のコスト削減は常時稼働型の導入を安く運用できる可能性がある。ただし数値はMiniMax自社の検証によるものだ。
誰に効くか1件の作業ごとに何度もモデルを呼び出すAIエージェントを構築する企業チーム(コード監査、ペネトレーションテスト、銀行業務のワークフローなど)は、呼び出しあたりの価格が下がり、応答も速くなる。主張された削減効果がMiniMax自社の検証以外でも成り立つかは未確認だ。
こういう要約が、毎朝あなたのメールに届きます。
MiniMaxはM3.1 Flashで、規模そのものではなく価格と速度で勝負に出ている。パラメータ数は4280億とM3からほとんど変わらず、速度向上は推論時の疎結合をより大胆にしたためだと説明する。つまり1リクエストあたりで稼働するモデル部分が少なくなる。推論は全リクエストで有効のままで、開発者はLowからMaxまでの5段階の工数レベルを選べるため、コストと性能を天秤にかけられる。
この投入はDeepSeekのV4.1-Flashに真っ向からぶつかる。オフピーク時の入力は100万トークンあたり同じ15セントだ。MiniMaxの自己申告値では、ソフトウェアエンジニアリング分野で両者は接近している。M3.1 FlashはDeepSWE v1.1で73.7%を記録し、DeepSeekの公表値77%に対抗する。いずれの結果も第三者検証は受けていない。Bloombergによると、元のV4.1-Flashが9月に登場した後、MiniMaxの香港株は下落した。今回の投入の背景にある価格圧力は、すでに株価に表れている。
今回の発表は小さな謎も解いた。9月下旬にOpenRouterのルーティングサービスに現れた匿名モデル「Space Bunny」は、M3.1 Flashの初期ビルドだったと本日確認された。製作者が不明のまま200兆トークン超がこのモデルを通過した。ただしこの確認以外に、毎秒200トークンというピーク出力の根拠や、ProモデルがFlashとどう異なるのかについてMiniMaxは明らかにしていない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
デジタル庁のGenaiは2025年5月から庁内で使われ、2026年5月に全省庁へ展開を開始、2026年度に約18万人での試行を目指す
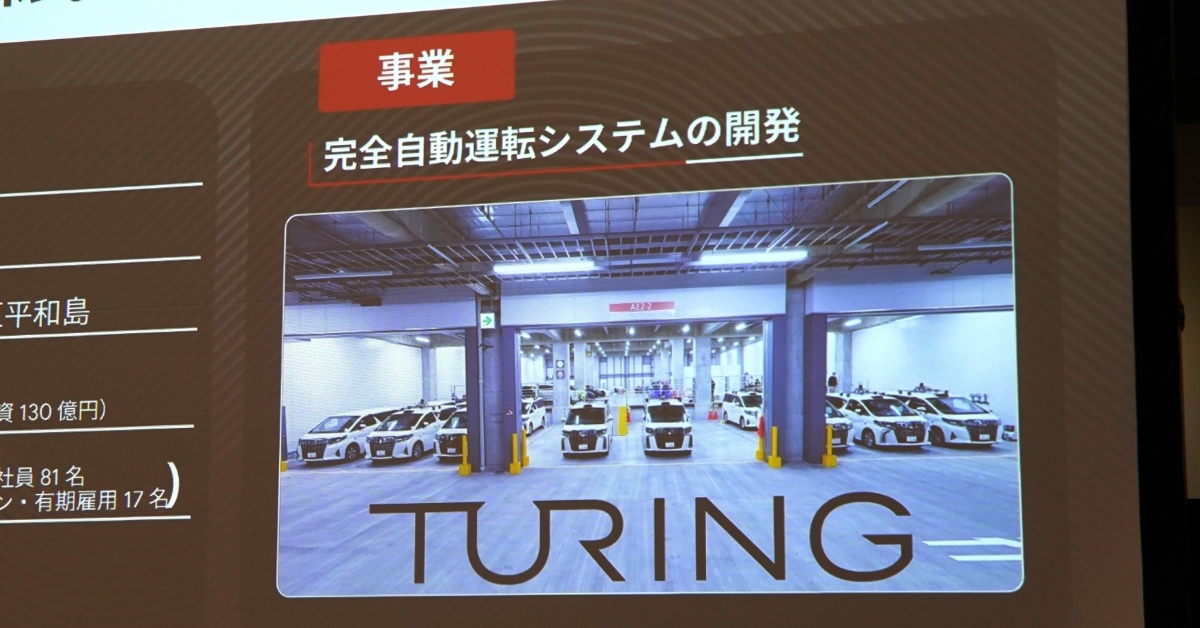
TuringのCTO山口雄は、データとGPUを増やすだけでは開発は速くならなかったと述べ、NvidiaとGoogleのチップを軸に計算基盤を再構築し、同じ価格で約3倍の速度を実現したと主張した
DHSは10月20日付通知で、国土安全保障長官がDeepSeekおよび関連IT製品・サービスの連邦民間調達からの排除と、DeepSeek実装の第三者製品の政府機関ITシステムからの除去を命じたと発表した
HPEは第6世代AMD EPYCプロセッサ搭載の初のHPE ProLiant Gen13サーバーを発表した
Slack、Teams、Chatwork、LINE WORKSに常駐するAIエージェントHACHの開発者が、数十秒から数分かかる依頼への対応3パターンを示した

R2-sanのMitateは間接プロンプトインジェクションを検知ではなく構造で防ぐ

