何が起きたか
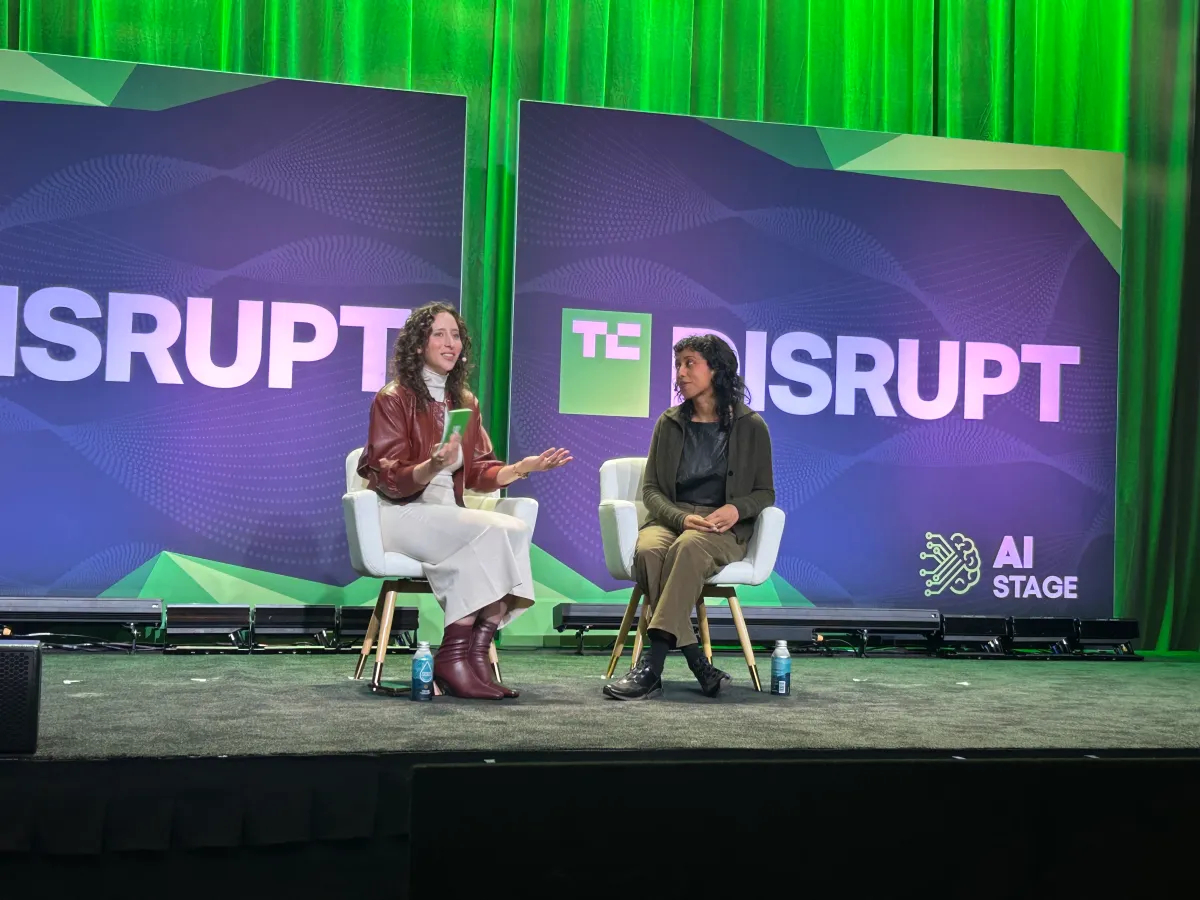
Hugging FaceのIrene Solaiman氏はTechCrunch Disruptで、評価は「進化する科学」で業界は有意な比較方法を知らず、評価は「比較的早く効果を失い始める」と語った。
なぜ重要か
結果を再現も比較もできないなら、優位性を主張する根拠となるベンチマークは購入者や規制当局にとって限られた保証しか持たず、第三者評価者の組み込みはそれを判断する基準整備を上回る恐れがある。
こういう要約が、毎朝あなたのメールに届きます。
ベンチマーク論争は、AIラボが評価結果に自らの評判を懸けるようになるにつれて大きくなってきたが、Solaiman氏によれば評価手法は複雑でなお成熟途上にある。再現性は以前からベンチマークの難しい側面の一つであり、同氏はあるテストを他の評価とどう比べるかという問題も加わると指摘した。
組み込み型評価者はここ数カ月、ラボが相次ぐ安全インシデントに対処する中で広まった手法で、Hugging Faceもその一つで有名な標的となった。ラボは政府の積極規制の代わりに第三者の解決策を推進してきたが、評価者が実際にどれほど中立で効果的かには疑問が残る。Anthropicが最初の評価者としてAccentureを雇った判断は、同コンサルティング会社の資格を嘲笑する批判者から反発を招いた。
評価はモデル単体から、ハーネスやエージェントを含む周囲のシステム全体へと移りつつある。Solaiman氏はエージェント評価は非常に難しく高コストだと述べ、エージェント全体に対する優れた評価が開発されつつあっても、ハーネスの評価はモデルの評価より少ないと語った。同氏は現在の評価状況を一種の無法地帯と表現し、ベンチマークを指導者にとって有用な道具であり続けさせるには、業界全体でより統一された手法が必要かもしれないと示唆した。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
MiniMax Group Inc.が6月のM3モデルの改良版M3.1 Flashを公開
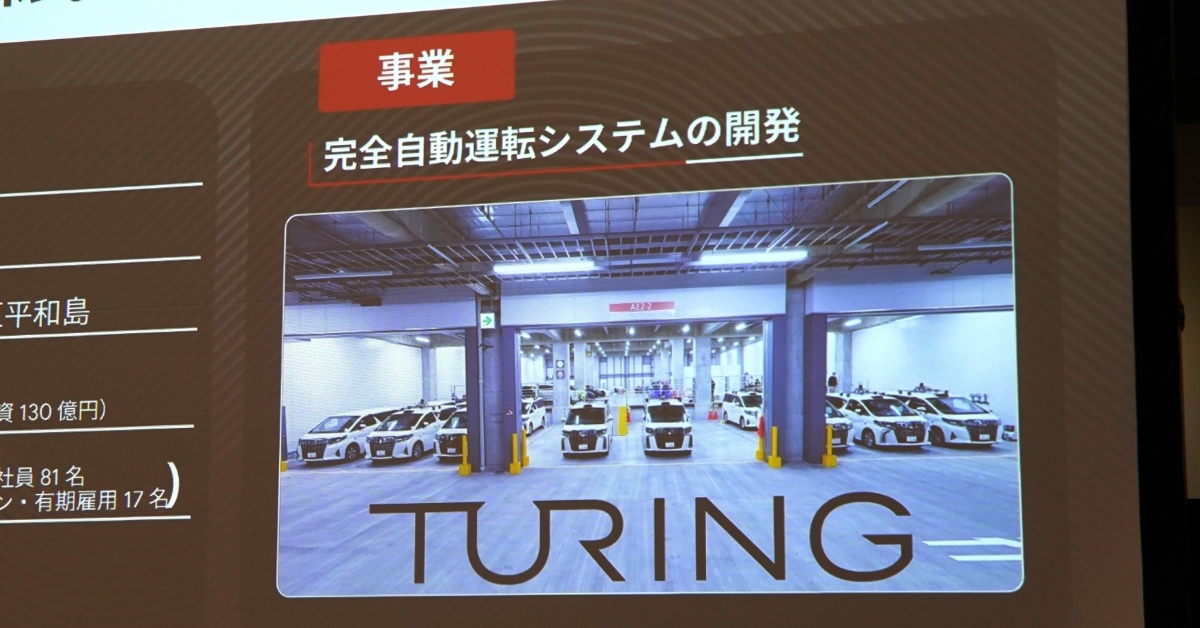
TuringのCTO山口雄は、データとGPUを増やすだけでは開発は速くならなかったと述べ、NvidiaとGoogleのチップを軸に計算基盤を再構築し、同じ価格で約3倍の速度を実現したと主張した
HPEは第6世代AMD EPYCプロセッサ搭載の初のHPE ProLiant Gen13サーバーを発表した
Alex G. Tse判事はAbdulrahman Alfozan被告に、サウジ政府の100万ドル保釈保証金を退け「一度出れば戻らない」として連邦拘留継続を命じた
R2-sanのMitateは間接プロンプトインジェクションを検知ではなく構造で防ぐ

CoreWeaveの債券が不良債権領域に陥った