何が起きたか
AWSはRay Train DLCのタグ「train-ml-cuda-v1.1」を公開した。
なぜ重要か
このイメージにより、チームはCUDAやNCCL、EFAなどのバージョンを自前で揃えてビルドする作業から解放される。
注目点
このサンプルはQwen2.5-1.5Bを8基のNVIDIA L4 GPUでFSDP微調整する構成で、GPUインスタンス稼働時のコストは時間約9.50ドルとされている。
誰に効くかPyTorchで複数ノードの分散学習を運用する機械学習エンジニアや、社内の訓練基盤を保守するインフラ担当者に影響する。コンテナのビルドとバージョン整合の負担が減り、モデルコードと設定に集中できるようになる。
こういう要約が、毎朝あなたのメールに届きます。
分散学習のボトルネックはモデルコードではなくコンテナの準備にある。CUDA、PyTorch、NCCL、EFA、AWS OFI NCCLプラグインのバージョンを揃え、変更のたびに再ビルドする作業はモデル開発とは別のプロジェクトになりがちだ。AWSはこのスタックを1つのイメージとして組み立て、Amazon ECR Publicで公開し、パッチ適用まで担う。
特にネットワーク層の不一致はエラーを出さず、NCCLがTCPソケットに落ちて速度だけが落ちるため、気づきにくい。DLCではこれらのライブラリが一緒にビルド・テストされ、AWSがマルチノードEFAとマルチノードKubeRayの訓練テストで各リリースを検証している。利用者はイメージを変更せず、インスタンス種別やGPU数、ネットワーク設定、追加パッケージを外部から指定するだけで済む。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
サカナクション山口一郎が10月27日のYouTube生配信で、パスタに混ざったカメムシの句をChatGPTに頼むと、「うんうん、聞いてるよ」と相づちだけを返し、「こんな壊れ方するの?
IteraのLLMOチェキが「AI質問の提案」を開始

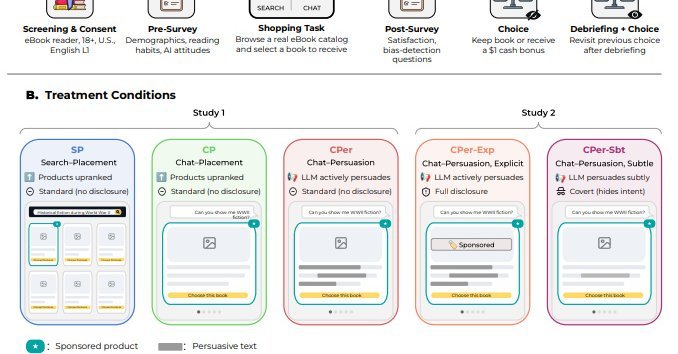
プリンストン大学の研究で、参加者2,012人と約5,500冊を使い、広告商品の選択率は検索結果経由22.4%、中立のチャット配置26.8%、AIに秘密裏に説得を指示すると61.2%だった
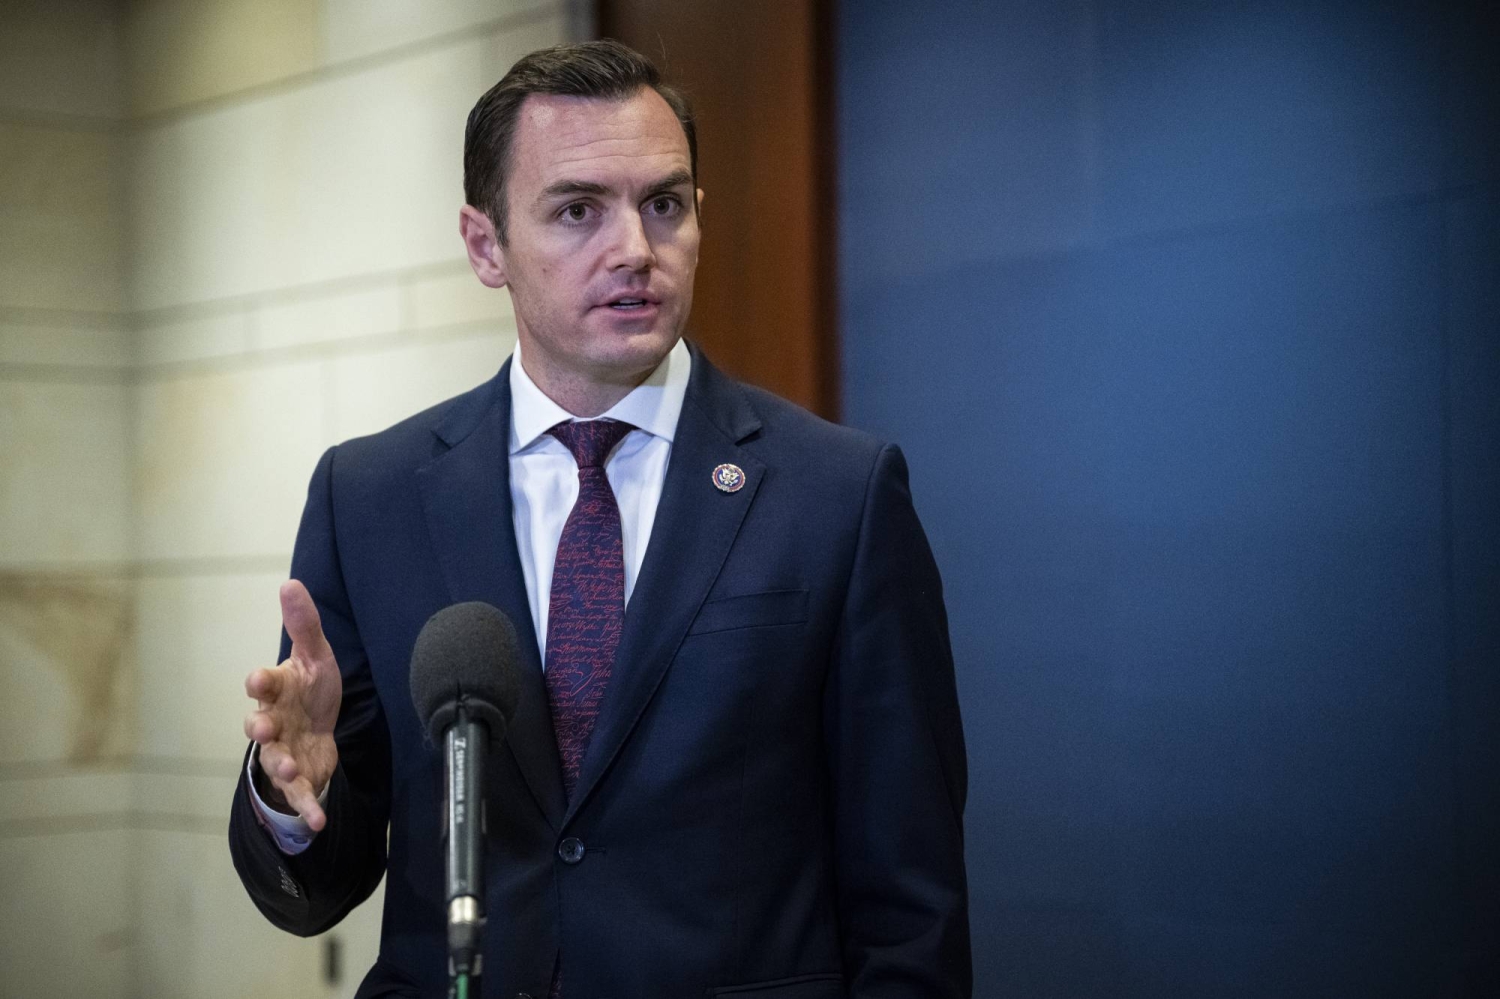
Palantirの防衛部門責任者Mike Gallagher氏は水曜日、AI開発における台湾の役割が増大し、習近平国家主席が北京の台湾構想を実行に移す必要が生じかねないと述べた
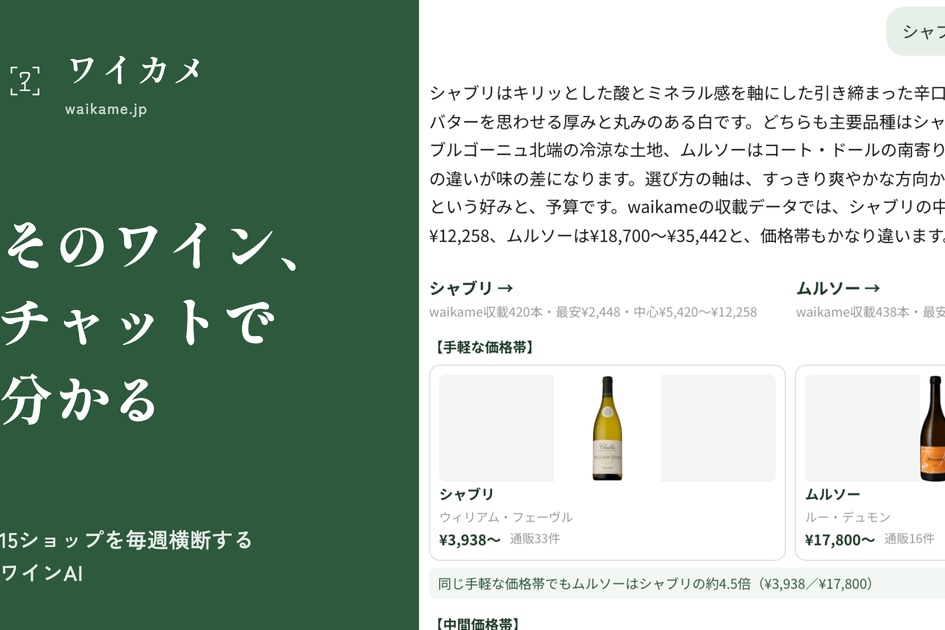
Project Tadoriの「ワイカメ」が10月29日、無料の対話型トップページを公開
NTT TechnoCrossは12月からForeSight Voice MiningにAIナビゲーションを追加