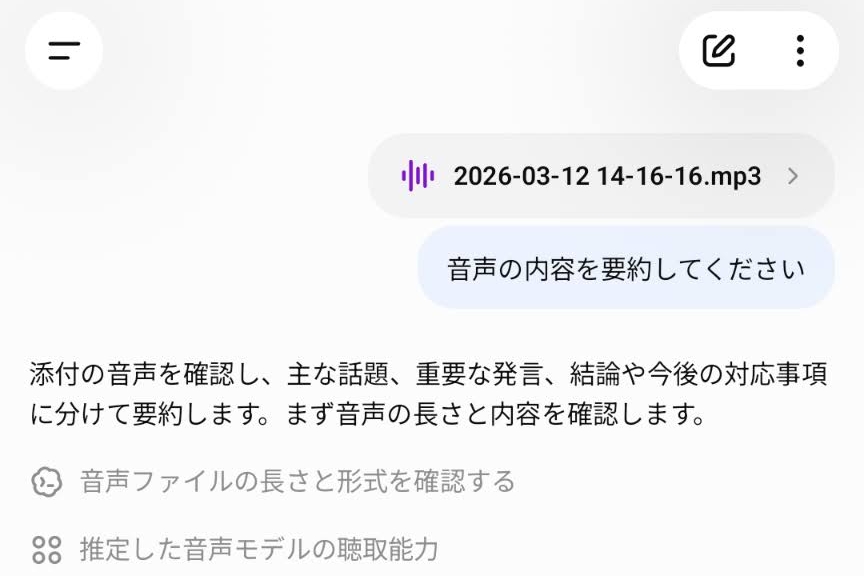
OpenAIがChatGPTで音声ファイルのアップロードに対応し、文字起こしや要約、内容に関する質問への回答が可能になった
NECネクサソリューションズが2026年10月6日、「対話型音声AIエージェント Powered by DEN.Ai」の提供を開始
Automation Anywhereは水曜、会話型音声AI企業Boost.aiをNordic Capitalから買収する合意を発表した
AI音声入力アプリ「Willow Voice」のWillow Care Inc.が、モデル訓練の基盤にCoreWeave Inc.を選んだとCTOのLawrence Liuが明らかにした
アブダビのTechnology Innovation Instituteがアラブ首長国連邦のアラビア語方言で学習した「Falcon-Emirati」と音声認識・画像文字抽出ツールを公開した
Google LLCがSynthID Detectorを公開
FCCは中間選挙前にAIで作成したものを含む政治ロボコールを増やせるようにすることを検討している
GoogleはブラウザベースのAIプラットフォーム「Playground」を公開
2026年8月登場のGoogleのGemini 3.5 Transcribeは文字起こし専用モデルで、最大8人の話者分離、単語ごとのタイムスタンプ、単位の自動正規化に対応する

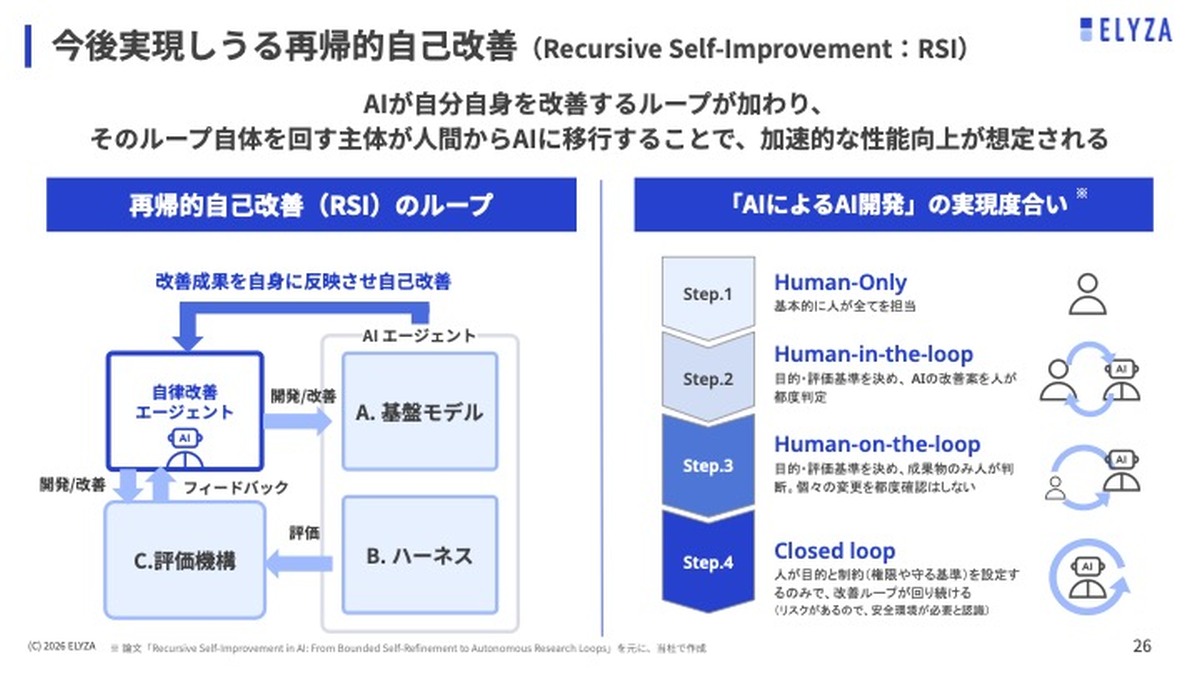
ELYZAが2026年10月2日、再帰的自己改善RSIの研究組織「ELYZA RSI Research」を立ち上げ、音声対話AI「ELYZA Voice Agent」も紹介した
キクレンの開発者が相談者AIをgpt-realtime-2.1からGPT-Liveに切り替え、相づちのたびに発話が止まる問題が解消した
開発者はKoehaku音声ランタイムにNemotron 3.5 Streaming ASR 0.6B 560ms INT8を追加し、100ターンのテストで発話終了からp50 1.594秒を計測した
Sean ParkerとPrem AkkarajuがStability AIを音楽ツール企業として再建中
MicrosoftとLG ElectronicsがソウルでSpeech-to-Speech AIエージェントを発表
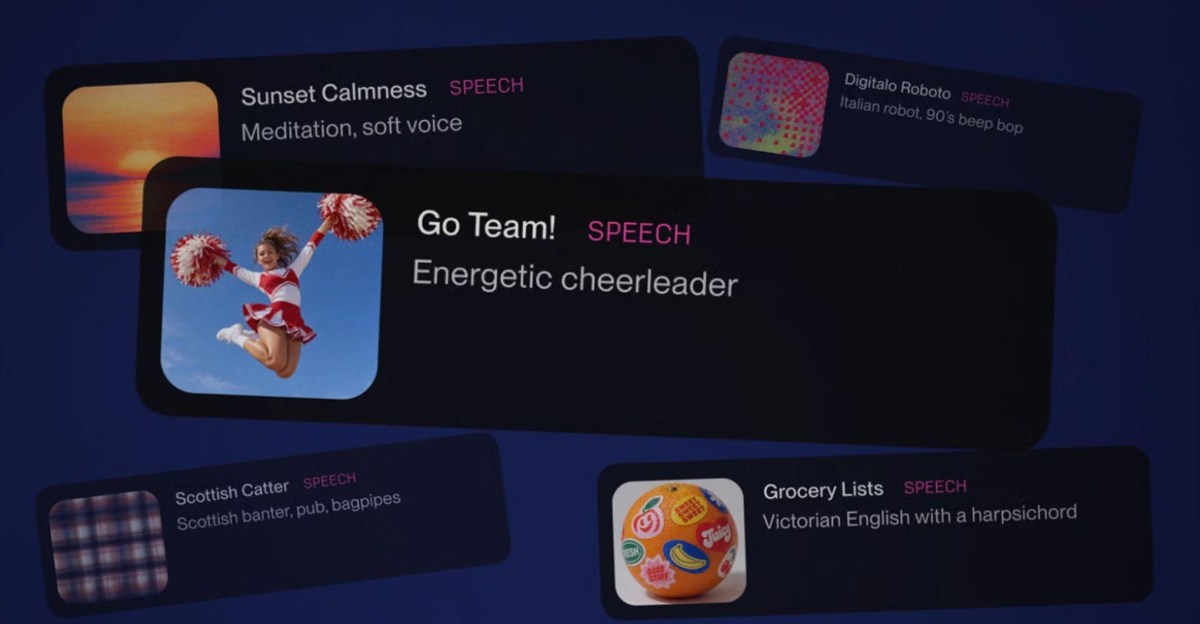
AI音楽生成のSunoが、入力したテキストを朗読とそれに合うBGMにして1曲にまとめる「Speech」を公開
AIカバーは原曲からボーカルを分離し、RVCなどで別の声に変換してから伴奏とミックスする3ステップで作る

英語とフランス語の制御されたHuBERT設定で、補助言語分類器と言語別k-meansターゲットの2つの介入により、音素ABX誤り率が11.6%から10.4%に低下し、単言語の10.8%を下回った
Microsoft AIがMAI-Transcribe-2-Streamingを発表
SunoがWebとモバイルでSpeechの公開ベータ版を開始し、スクリプトやプロンプトからナレーションとBGMを一緒に生成できるようにした
Microsoftが初のストリーミング文字起こしモデルMAI-Transcribe-2-Streamingを公開
Microsoft AIはMAI-Transcribe-2-Streamingを公開
Microsoftは2026年10月1日にMAI-Transcribe-2-Streamingを公開
StarkeyがOmega AI+を発表
Airbnbは今週、AI検索を秋のアップデートの一環として展開した
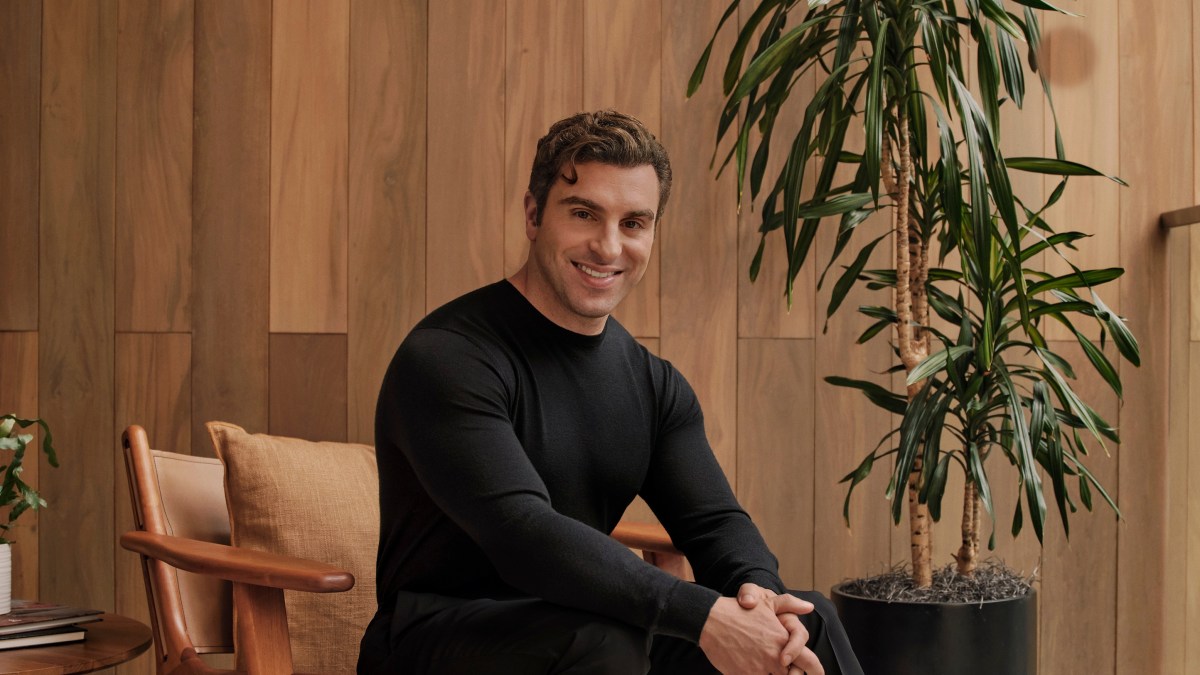
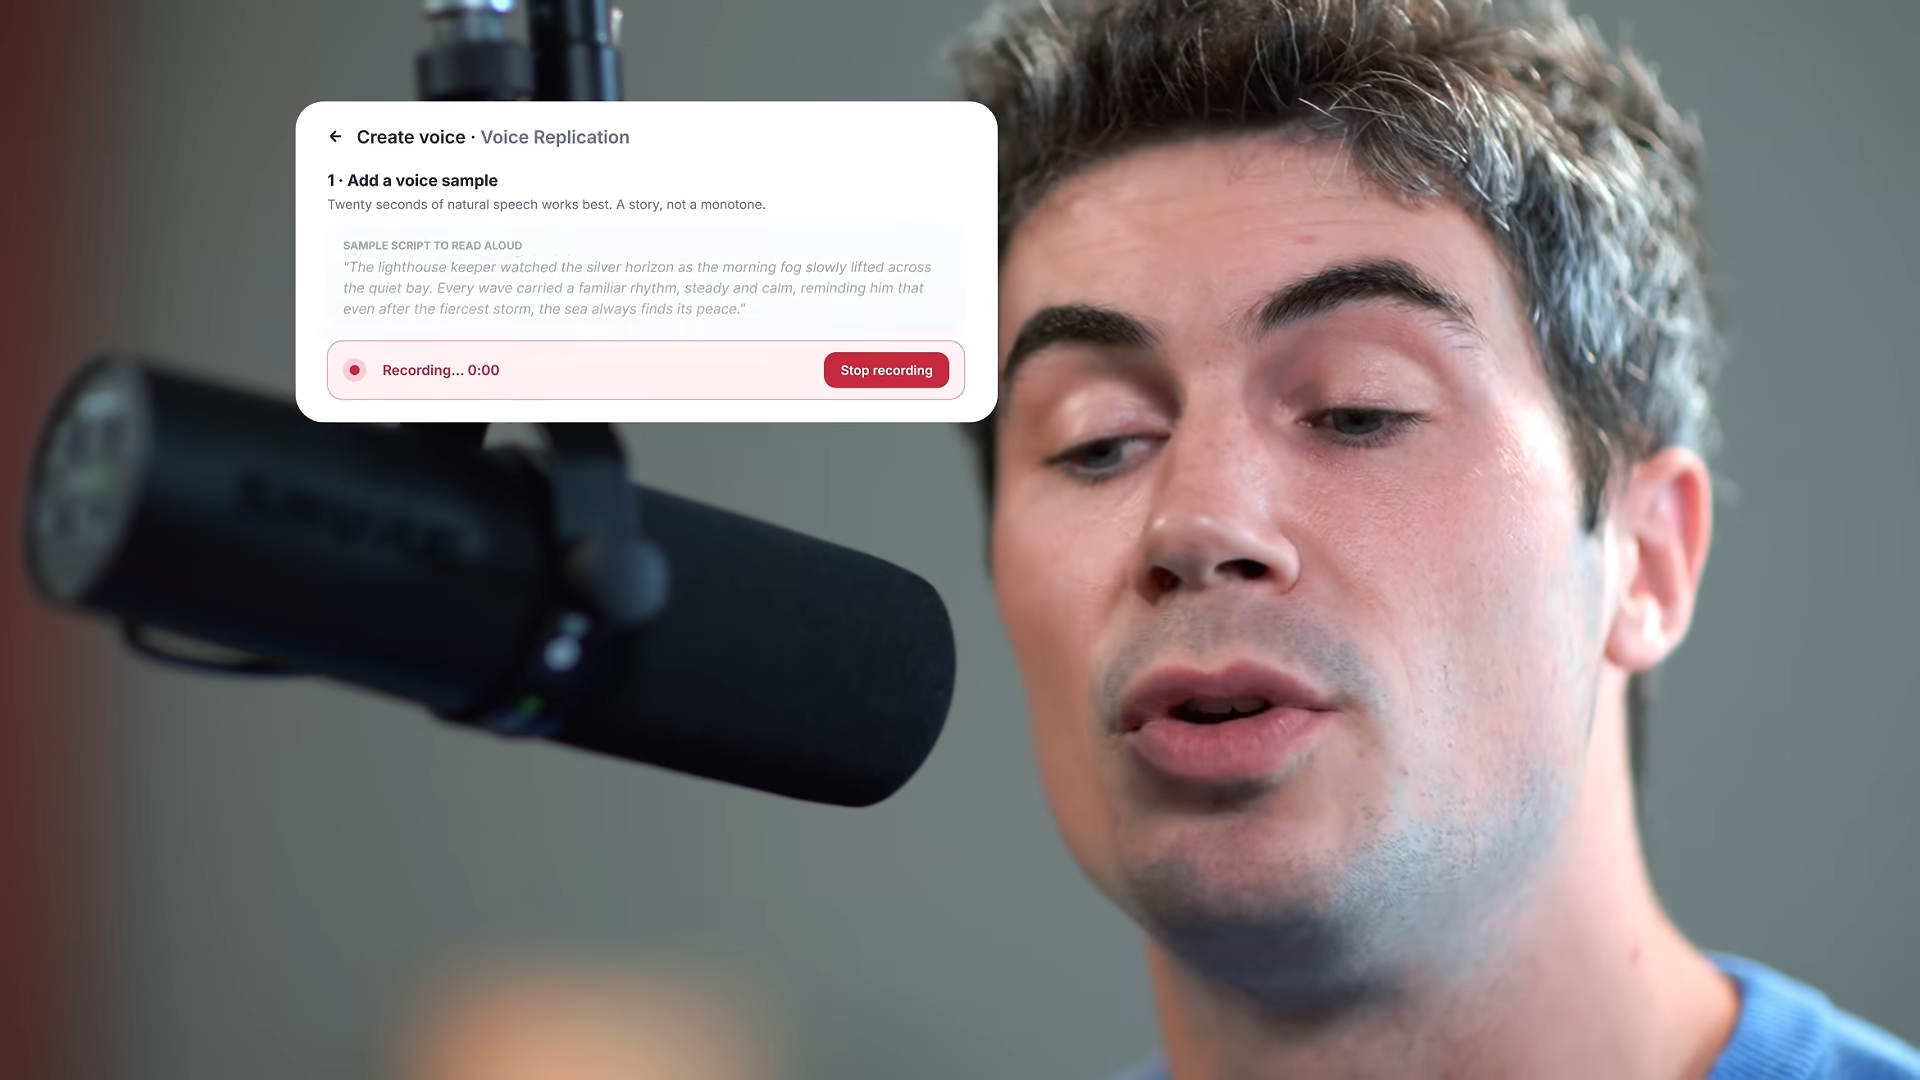
CreatuneのAlex氏によると、現在のAIカバー画面は二つの方向を選べる
Redditのaudio.cpp分析が100以上の音声モデル間で共通部品を整理
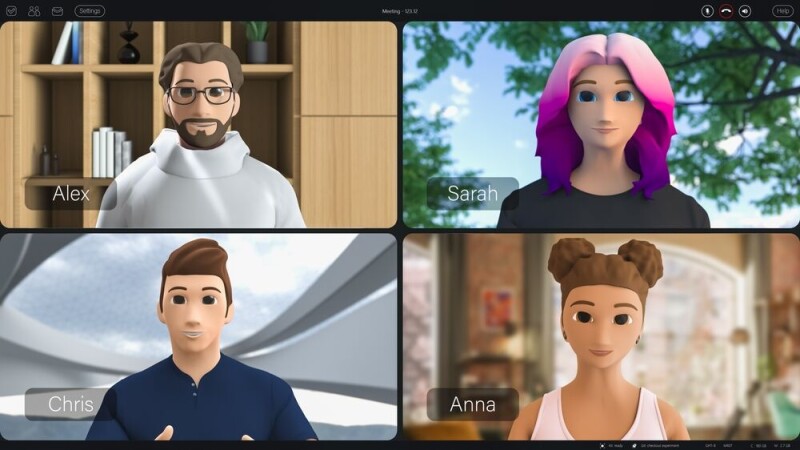
Aditya Shinde氏がMeetTwinsのベータユーザーを募集
ElevenLabsは従業員が既得株式の一部を220億ドルの評価額で売却できるようにした
Hugging FaceがOpen TTS Leaderboardを公開
GENIEEの技術ブログが2025年9月〜2026年9月の最多閲覧記事3本を発表
Hugging Faceのspeech-to-speechをRTX PRO 6000 Blackwell上で完全ローカル実行した
東京地裁は津田健次郎がTikTokにAI音声クローン動画の削除を求めた申し立てを、既に削除済みとして棄却
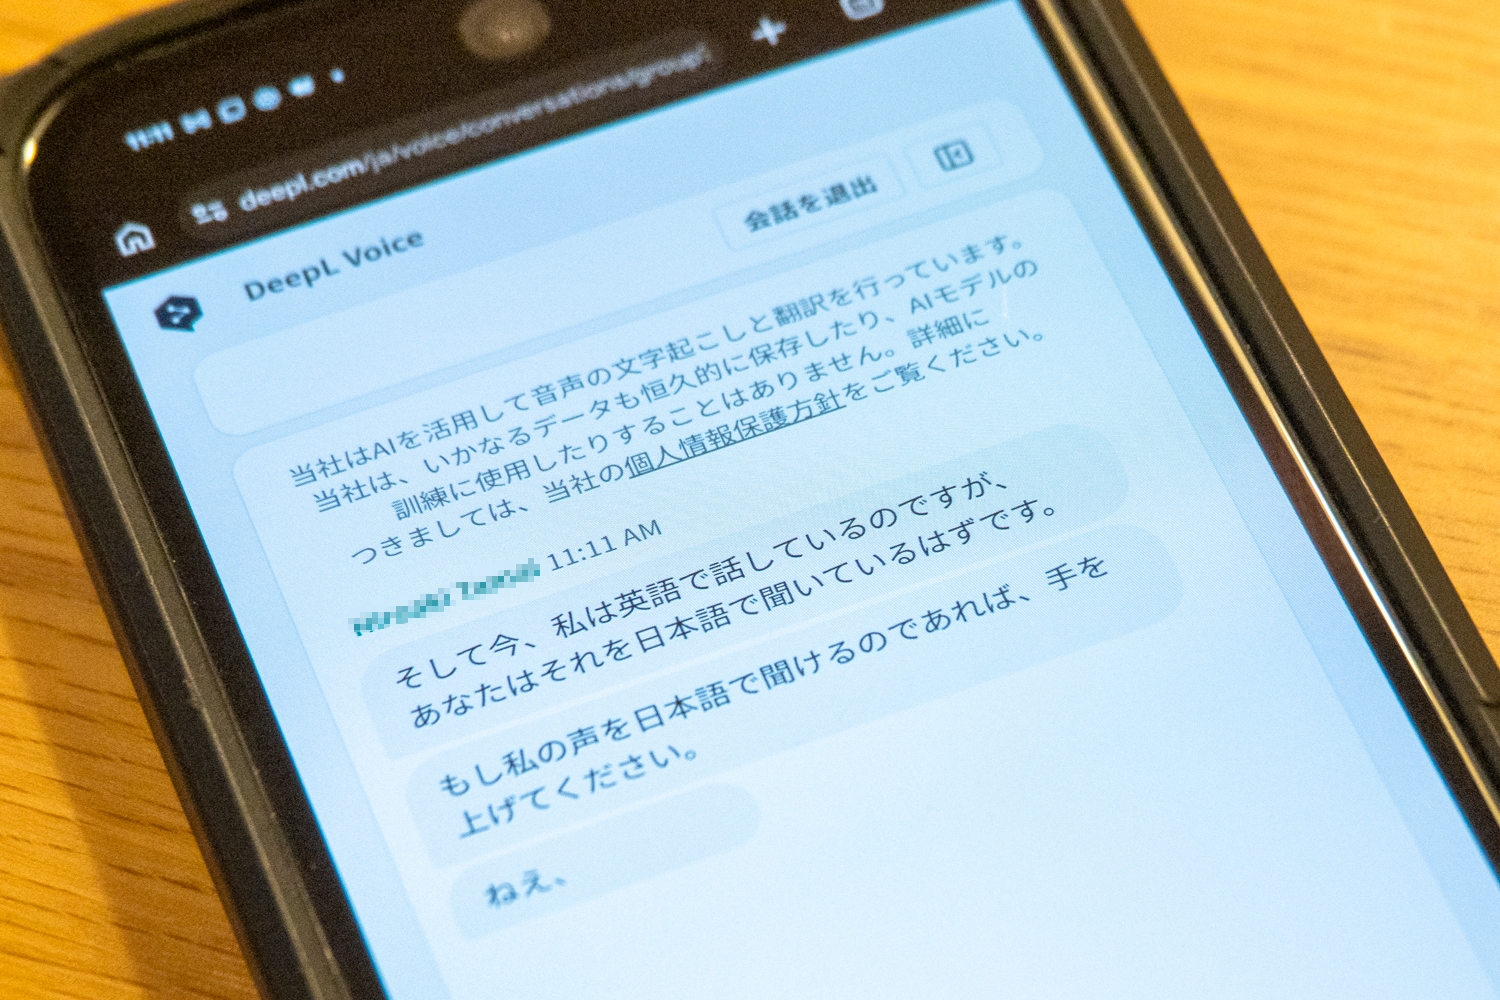
DeepLがDeepL Voiceで音声から音声へのリアルタイム翻訳を正式提供
ElevenLabsがEleven v4とTurboを公開した
AHSが9月29日、Synthesizer V 2用の歌声データベース2製品を発売
NTT西日本のVOICENCEは2026年9月28日、無料の「声の相談窓口」を開設すると発表
AIニュースを、今日の仕事につなげる。
100以上のソースから、その日の要点だけをEmail・LINE・Slackへ。無料で始められます。
月間読者 60,000+AWSはvLLM-Omni Deep Learning Containerを使いAmazon SageMaker AI上にQwen3-TTSを展開するチュートリアル第1部を公開
Modulateが2500万ドルを調達
ElevenLabsが「Eleven v4」と「Eleven v4 Turbo」を公開
Tarini Padmanabhuni氏創業のSan Francisco拠点DetectifAIは、スマホOS内で動く小型AIモデルで通話・音声メッセージ中のAI生成音声を端末外に音声を出さず即判定するSDKを携帯メーカ…
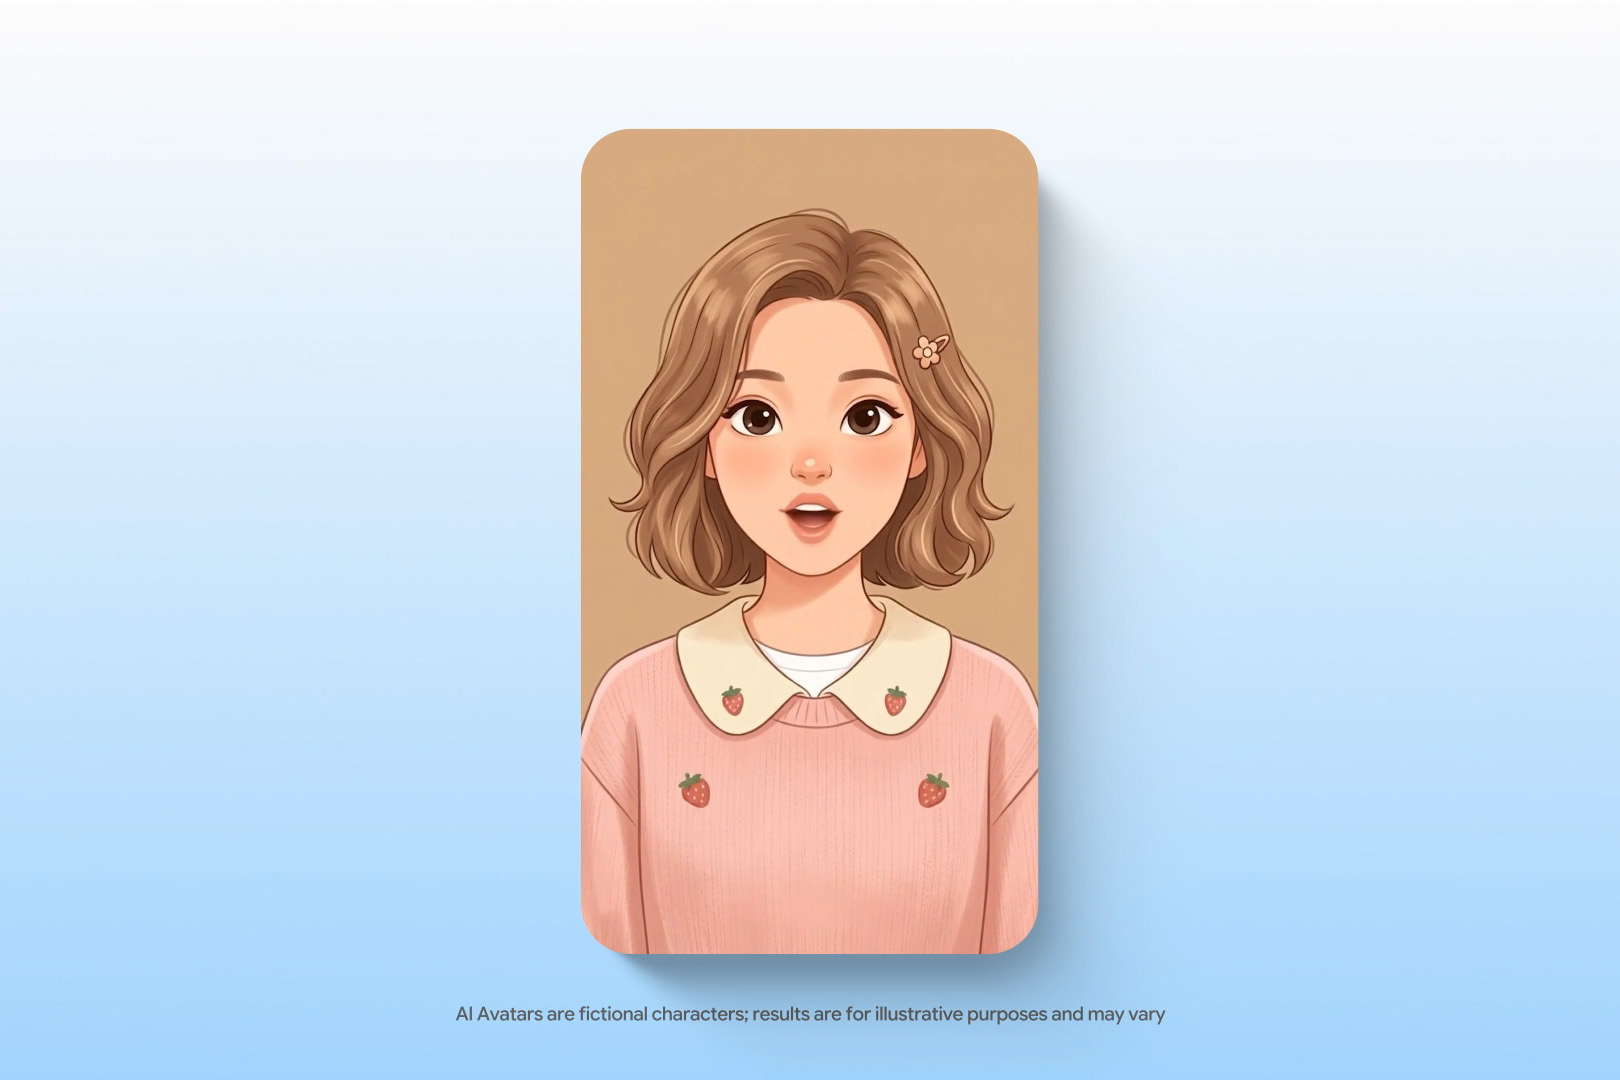
Googleは対話型音声モデルGemini 3.8 LiveにLive Avatar機能を搭載し、Gemini Enterpriseで利用可能になったと発表した
OpenAIは9月24日、ChatGPT Voiceが接続済みアプリやツールを使った作業に対応と発表
Googleが音声生成AI「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表
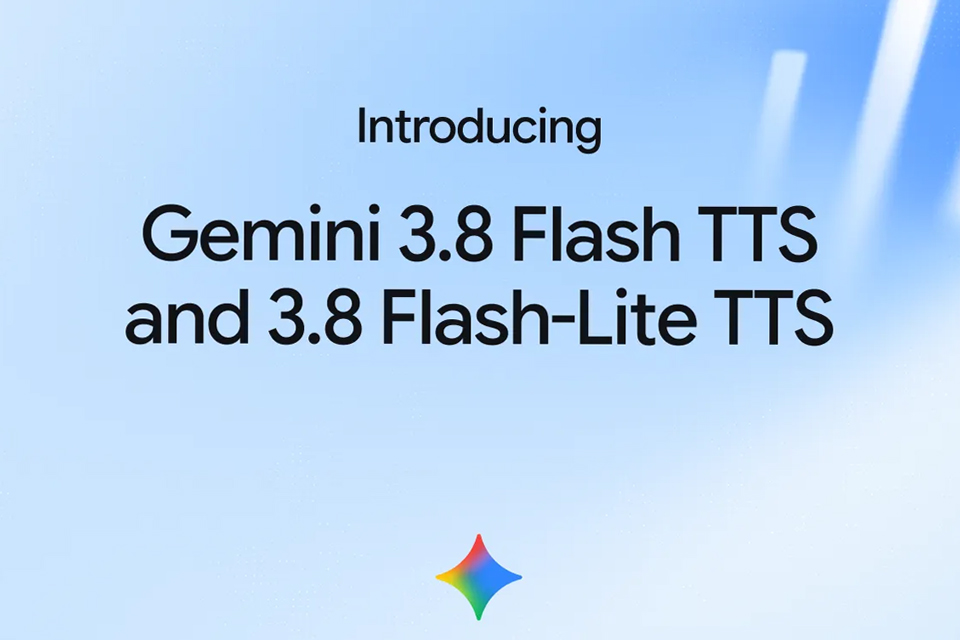
Nottaの「Notta Memo Pro」は、薄型ボディで素早く録音を開始でき、文字起こしと要約もこなすAIボイスレコーダー
Googleは「Gemini 3.8 Flash TTS」「Gemini 3.8 Flash-Lite TTS」「Gemini 3.8 Live with Live Avatar」を発表した
Nvidiaは約1億パラメータの無料AIモデルNemotron 3 Diarizationを公開
声優の津田健次郎氏が、自身の「艶のある」低音のAIクローンを使った動画を巡りTikTokを提訴
企業価値40億ドルのデジタルアバター新興企業Synthesiaが、ニューヨーク支社でTechCrunch記者のインタラクティブなアバターを作成
マクドナルドが英語とスペイン語に対応するAIドライブスルー「Archy」を公開
AWSはQwenチームのQwen3-TTS-12Hz-1.7B-BaseをAmazon SageMaker JumpStart経由でリアルタイムエンドポイントに導入する方法を詳説した
SonyとUniversal Music GroupがSunoを再び提訴
TechCrunchによると、Googleは「Call for Me」をテスト中
AWSがWhisperX Deep Learning Containerを公開
Appleの研究者が、System-wide Dictationを支えるトークナイザーの蒸留による圧縮方法を検討した
Googleはクラウド基盤でGemini 3.8 Flash TTSとFlash-Lite TTSを提供開始
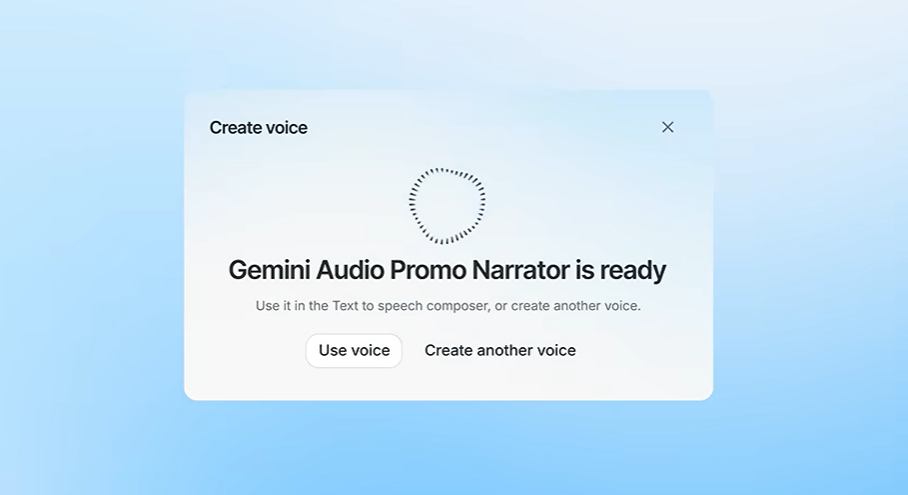
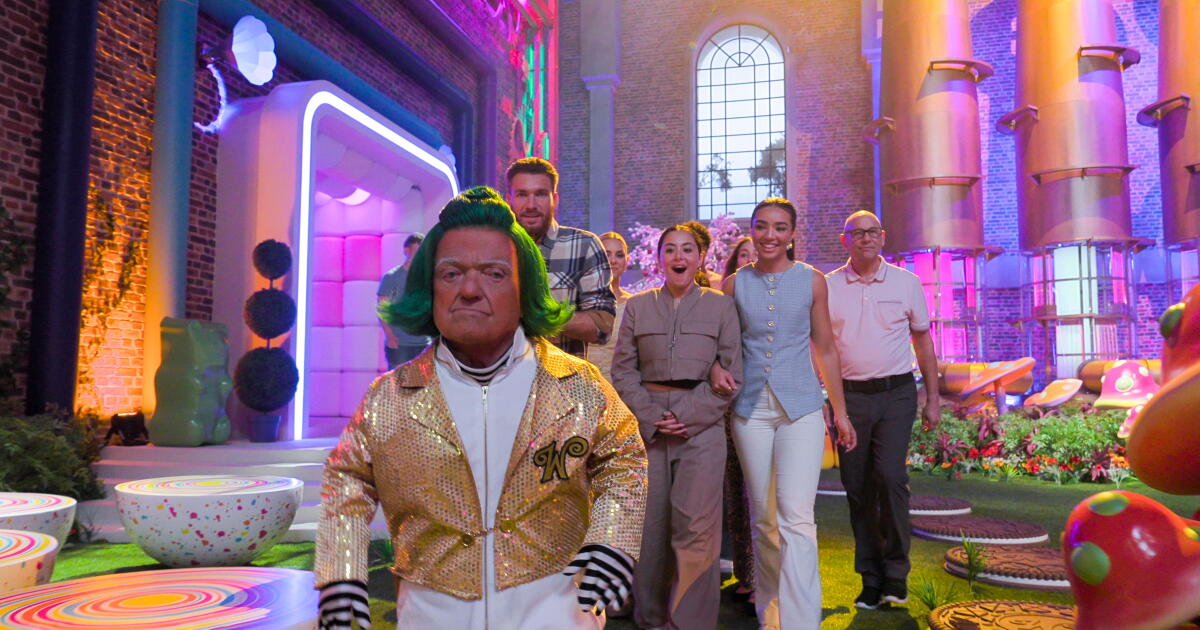
Netflixは1971年の映画を基にしたリアリティー競技番組『Wonka's the Golden Ticket』を水曜日に初公開
Googleはgemini-3.8-flash-ttsとgemini-3.8-flash-lite-ttsを公開
GoogleはGemini 3.8 Flash TTSとFlash-Lite TTSをGemini APIとGoogle AI Studioで展開
ChatGPT VoiceがOpenAIの新モデルGPT-6 Astra、Sol、Lunaで動作
YouTubeは「Made On YouTube」で、YouTube Musicの「Ask Music」と毎週AI生成の「Your Podcast Lineup」を発表した
NVIDIAが1億パラメータモデルNemotron 3 Diarizationを公開
AlibabaのQwenが音声認識・音声合成・リアルタイム対話向けの5モデルからなるQwen-Audio-3.1を公開し、TTS約70%、Realtime約85%、ASR最大95%の値下げを実施
週次まとめが新しい生成AI技術5つを紹介
テンセントのHunyuan Speechチームと大学の研究者がGanderを発表
マクドナルドが米国の一部ドライブスルーでArchIQと音声アシスタントArchyの限定テストを開始
アイスランドのTrebleがPaladin Capital Group主導で1800万ドルを調達した
Spotifyと業界団体がAI生成楽曲の表示・制限・禁止へ動き出した
Googleは9月15日にGemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表し同日提供開始
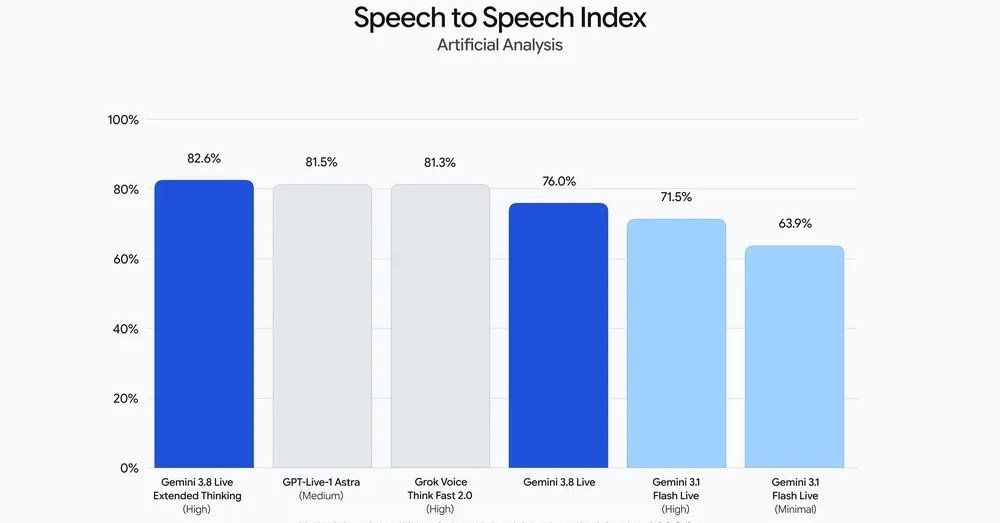
Google DeepmindがGemini 3.8 Liveと3.8 Live Extended ThinkingをGemini APIとGoogle AI Studioで公開
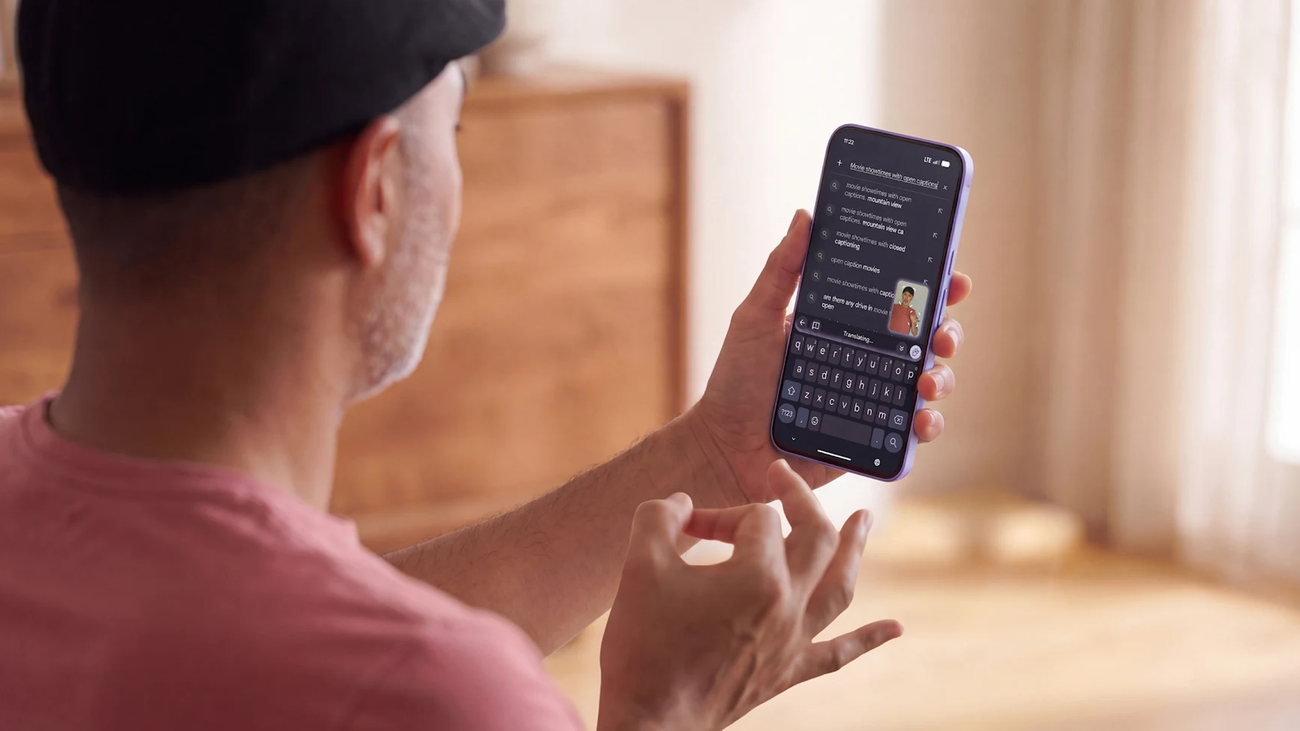
Googleは、言語技術が70億人超、世界人口の86%が話す300超の言語に対応し、Gemini 3.5 Live Translateが70言語のリアルタイム音声を処理すると発表した
Apple出身の研究者Fangchang Ma氏が率いるシアトルのスタートアップNuance Labsが、Lightspeed Venture Partners主導のシリーズAで5000万ドルを調達
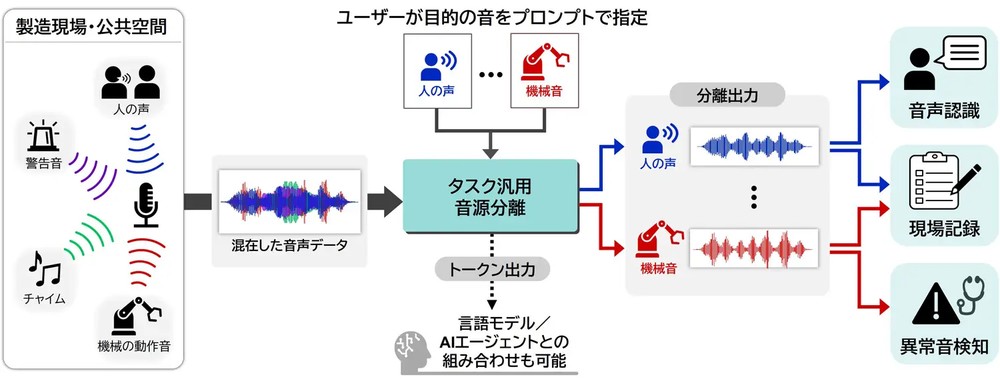
三菱電機は、音声や機械音、音楽などの種類をプロンプトで指定し混合音を分離する単一AIモデル「特定音源分離技術」を開発したと発表した
100以上のソースから厳選したAIニュースを毎日無料でお届けします。
月間読者 60,000+
無料で始める登録無料・Googleアカウントなら30秒・いつでも解除できます