ニコンは清華大学の寧徐氏のAI使用疑惑を調査し、受賞作品が規則に非準拠として失格とした
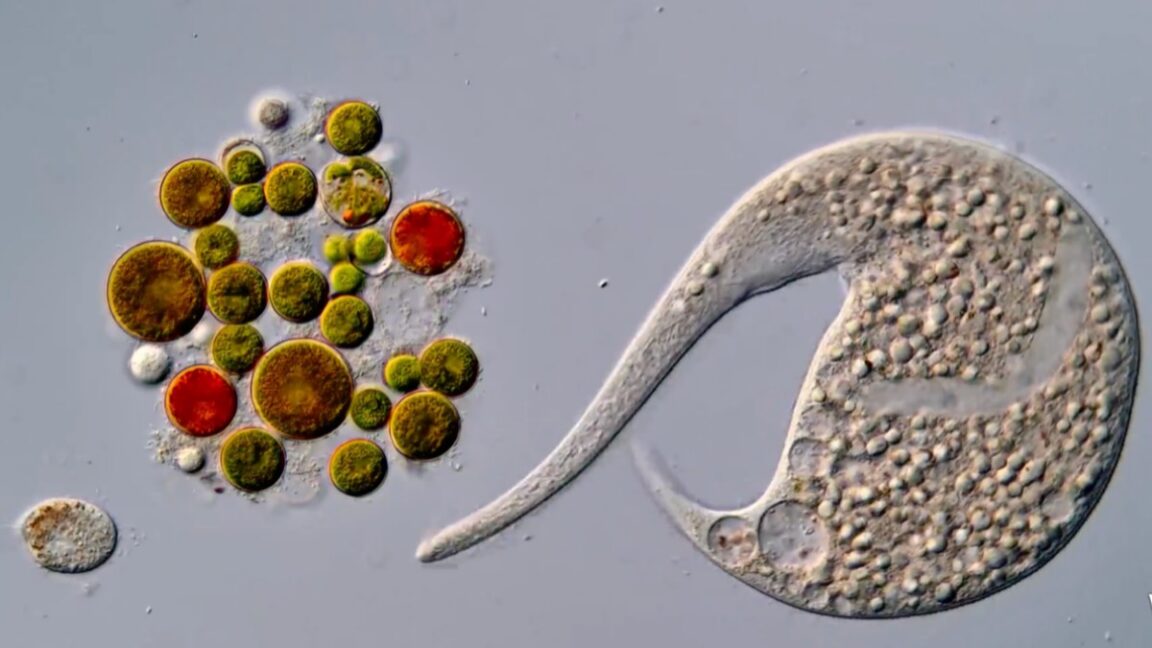
ニコンはNing Xu氏の「Small World in Motion」が生成AI規則に非準拠と発表
マーケターの記事が2026年10月7日時点の各社情報をもとに、日本語テキストを直接バナーに描画する用途でGoogleのNano Banana Proを最有力候補に挙げた

Show HNに「Anvil」が投稿された
Appleの研究者がNormalizing Trajectory Models(NTM)を発表
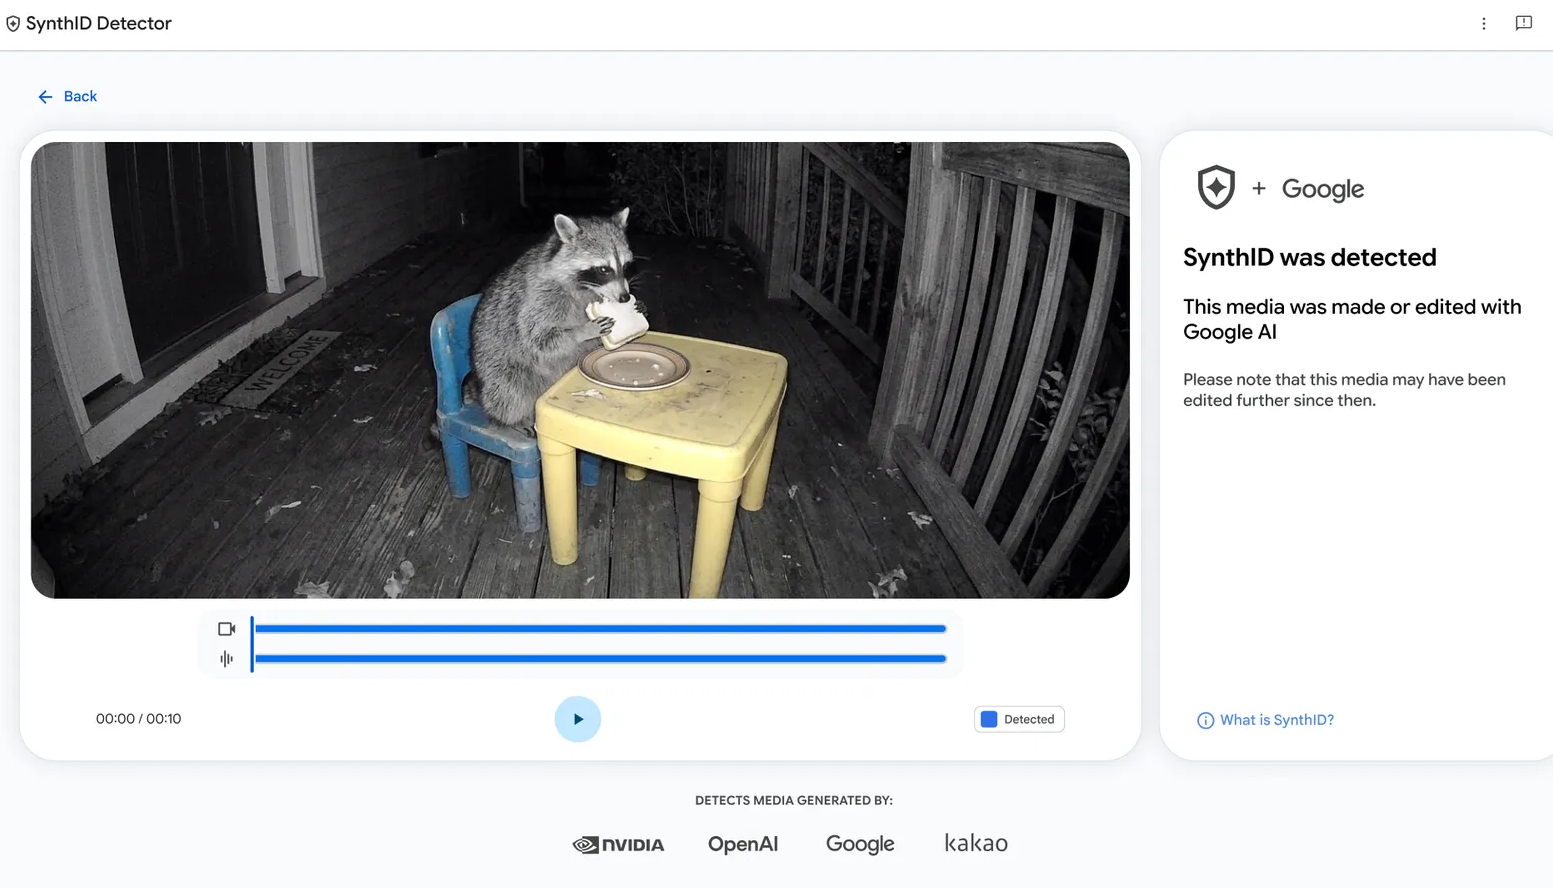
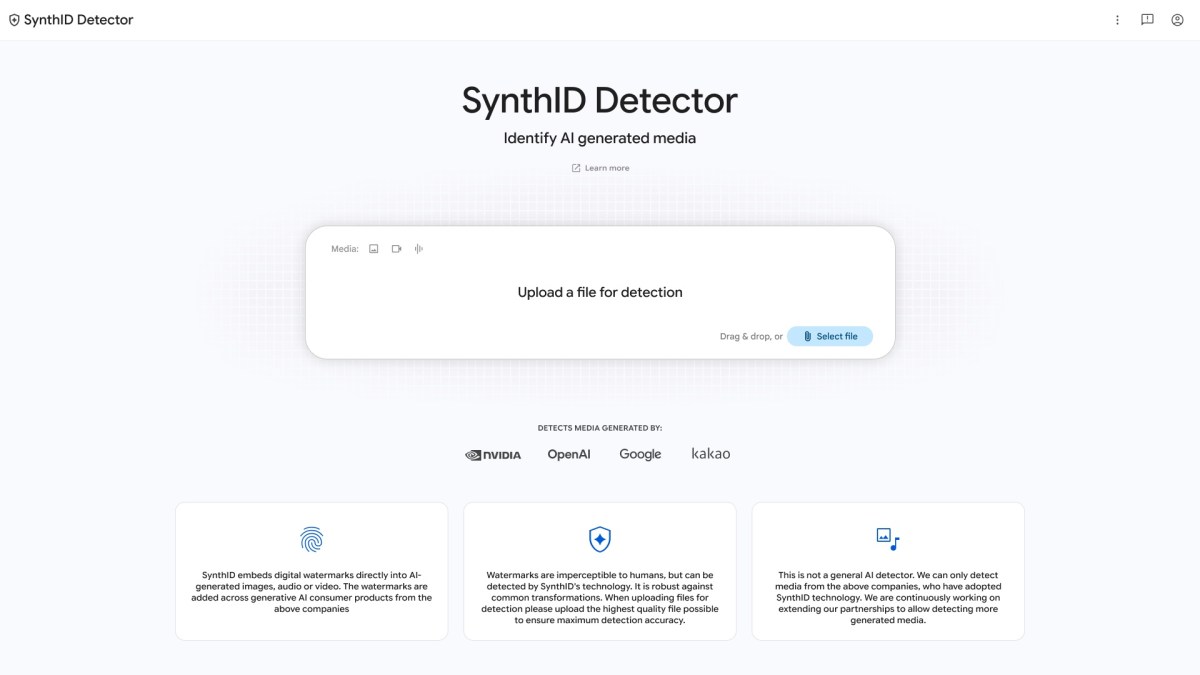
Google LLCがSynthID Detectorを公開
PetaPixelの報道によると、身元不明の開発者がAIを使い、Photoshop、Premiere、Lightroomの無料のオープンソース版を再構築した
GoogleはブラウザベースのAIプラットフォーム「Playground」を公開
Qwenは2026年9月20日、7Bの生成トランスフォーマー、32層、デフォルト2048×2048、入出力4チャネルのVAEを備えたQwen-Image-2.1を公開した

Googleは、画像・動画・音声がAI生成かどうかをSynthIDで判定する新たな公開サイトを立ち上げた
ユーザーはNew Yorker風の漫画をChatGPTに頼んだだけだが、Brendan Loperの「BLoper」署名が自動で追加された
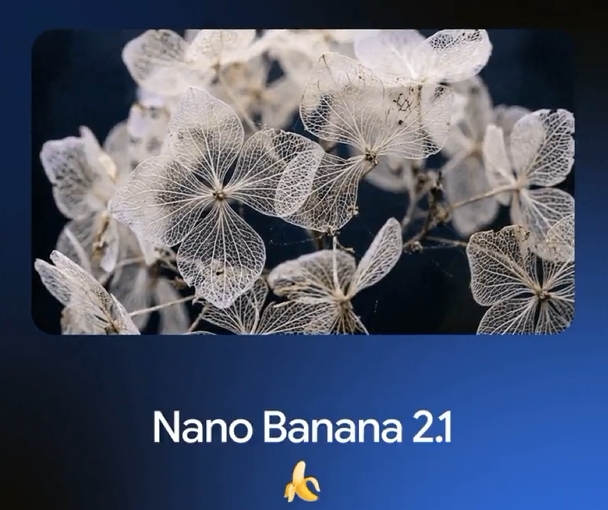
Googleが「Gemini Nano Banana 2.1」を一般提供した
JANCTION Renderが無料ベータを公開
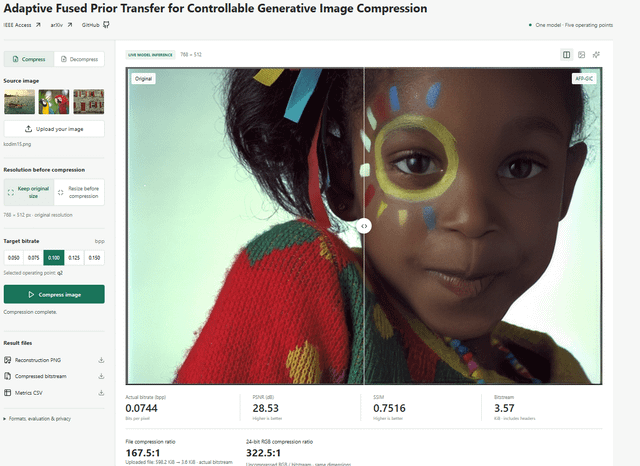
IEEE Access(2026年)掲載のAFP-GICは、デコーダ遅延をDC-VICの98.27 msから18.1%減の80.47 msに短縮し、1つの学習済みモデルで5つの目標ビットレート動作点を切り替えられる
GoogleがNano Banana 2.1を公開
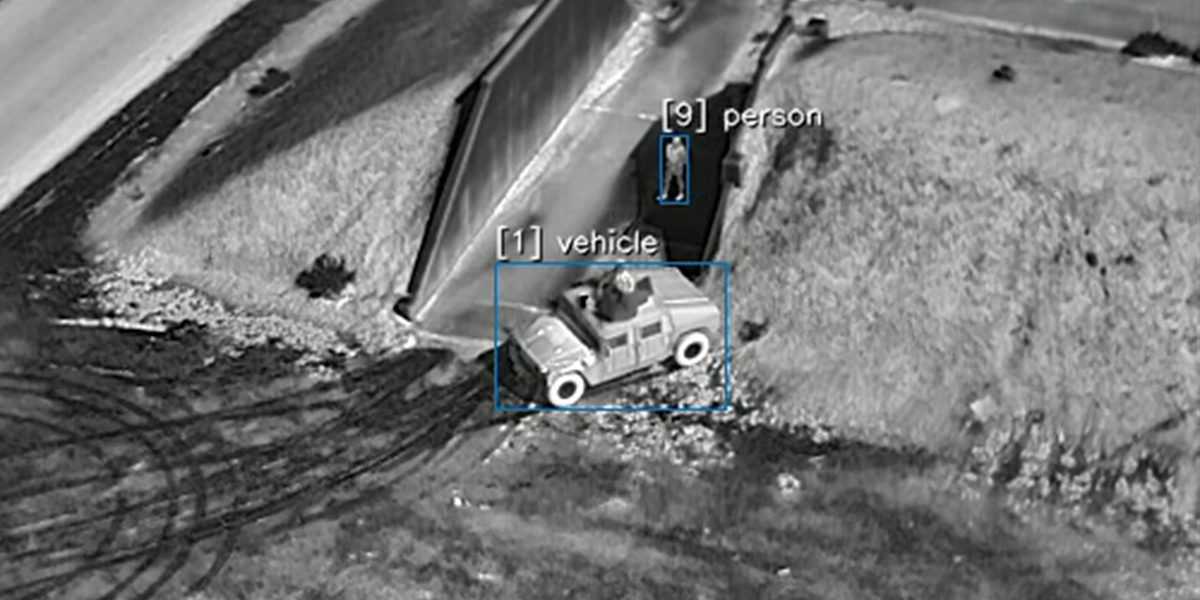
Teledyne FLIR OEMは10月6日、UASなどの空中ISRプラットフォームから複数の地上物体をAIでリアルタイムに検出・分類・追跡するソフトウェア「Prism A-ISR」を発表した
Overview AIがOV SparkとOV Spark Proを発表
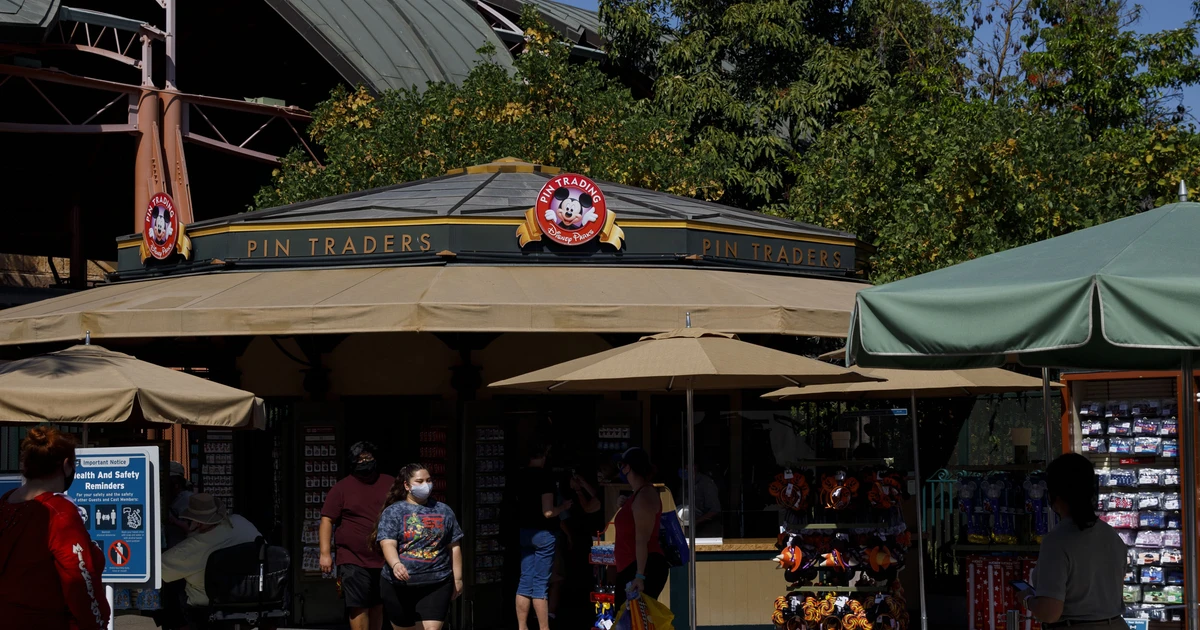
Catherine Esperanza Amador氏が10月2日、Pin Trading Appと共同創業者Andy Nguyen氏を提訴
OpenAIは今月下旬、ChatGPTが画像を生成する画面の下に表示するディスプレイ広告のテストを始める
MITライセンスのビューアmoodboardがmacOSにbunで導入でき、画像・動画・音声を1つの窓に並べて見比べ、選んだものを残せる
レオ14世は金曜朝のX投稿で「人間の芸術と機械が生み出すものを区別することが急務になりつつある」と述べ、両者には「存在論的な差異」があると指摘した
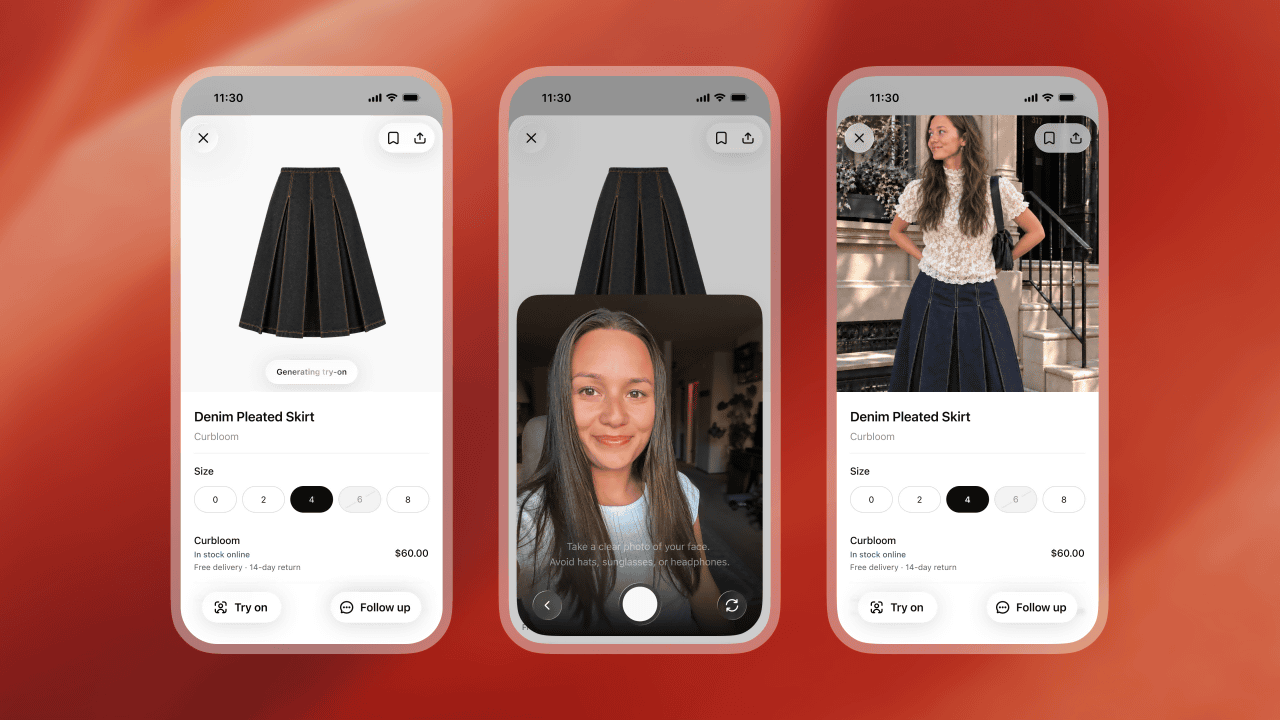
OpenAIがChatGPTに「Try on」ボタンを追加
Black Forest Labsが基盤モデルFLUX 3を使うFLUX 3 Imageを公開
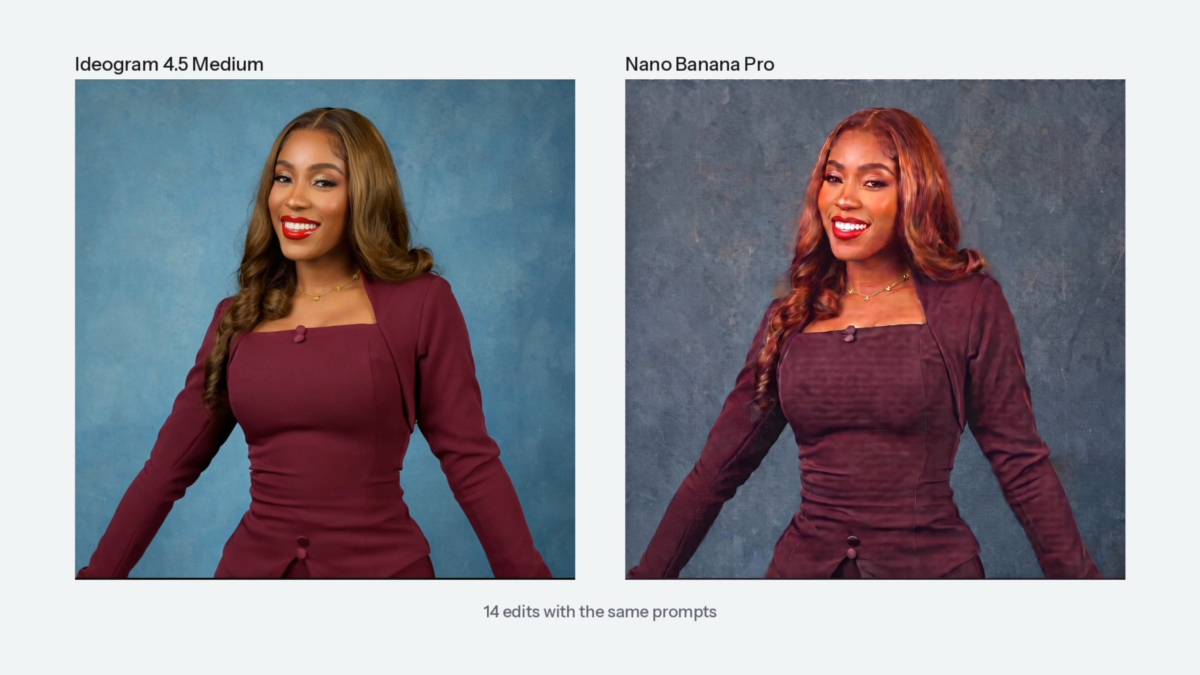
IdeogramがIdeogram 4.5を発表
AlibabaのQwenチームが2026年9月20日、Qwen-Image-2.1をオープンソース化
記事は参照画像を被写体と構図、光と背景、雰囲気の3要素に分けて整理する方法を勧め、Promptelleの画像→プロンプト生成ツールなら草案を作れるとしている
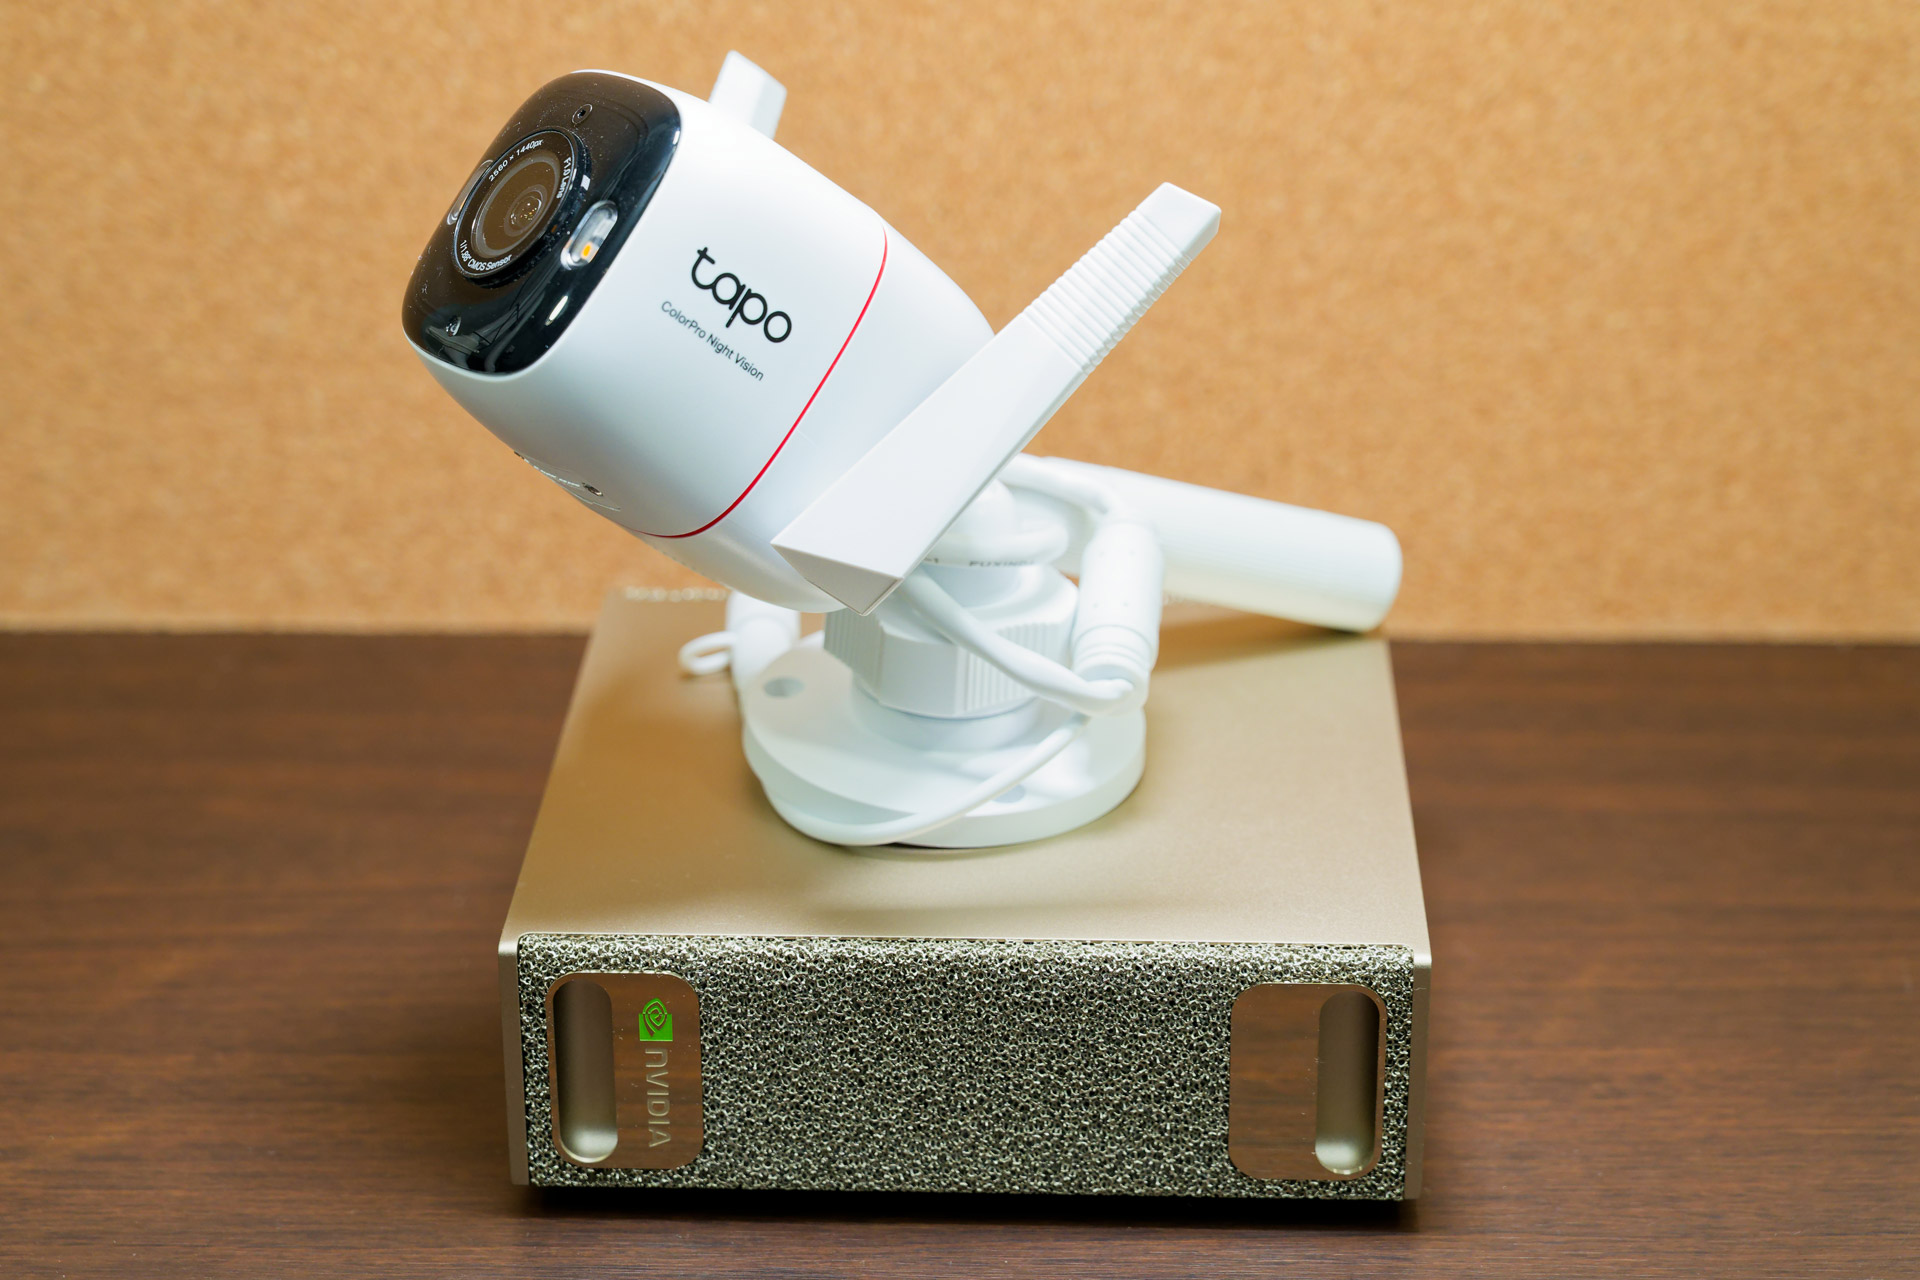
筆者はローカルAI監視カメラシステムを128GBのDGX Sparkに移し、Qwen 3-VL 30B A3Bとリアルタイム解説を追加
画像生成AIの数学を扱うQiita連載7回が完結し、Denoising Score Matchingから拡散モデル、Flow Matchingへ至る系譜をたどった
AMDは、Fei-Fei Li氏が率いるAI企業World Labsを約82億ドルの全株式交換で買収する最終契約を締結したと発表
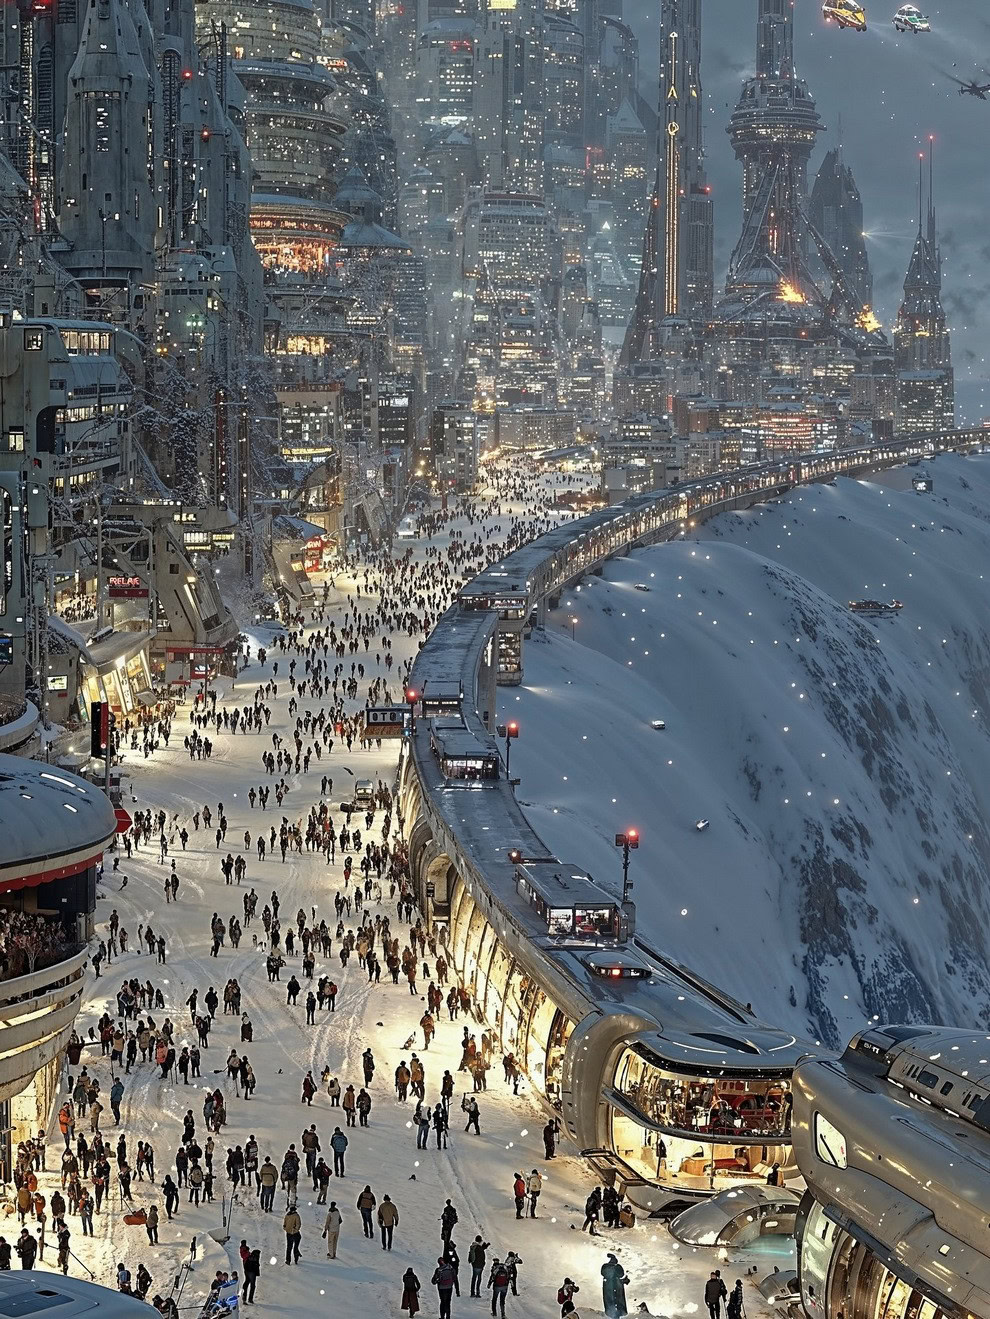
英国人フューチャリストで3D空間デザイナーのCorey Danaherが、Midjourney、Adobe、Luma AIを使い、AI駆動の建築で都市環境を再構想
AWSはvLLM-Omni Deep Learning ContainerでFLUX.2-klein-4Bをリアルタイム推論、Wan2.1-VACE-1.3Bを非同期推論で動かすサンプルを公開した
Adobeは2026年9月、Google Gemini向けコネクタとClaude向けプラグインを拡張すると発表
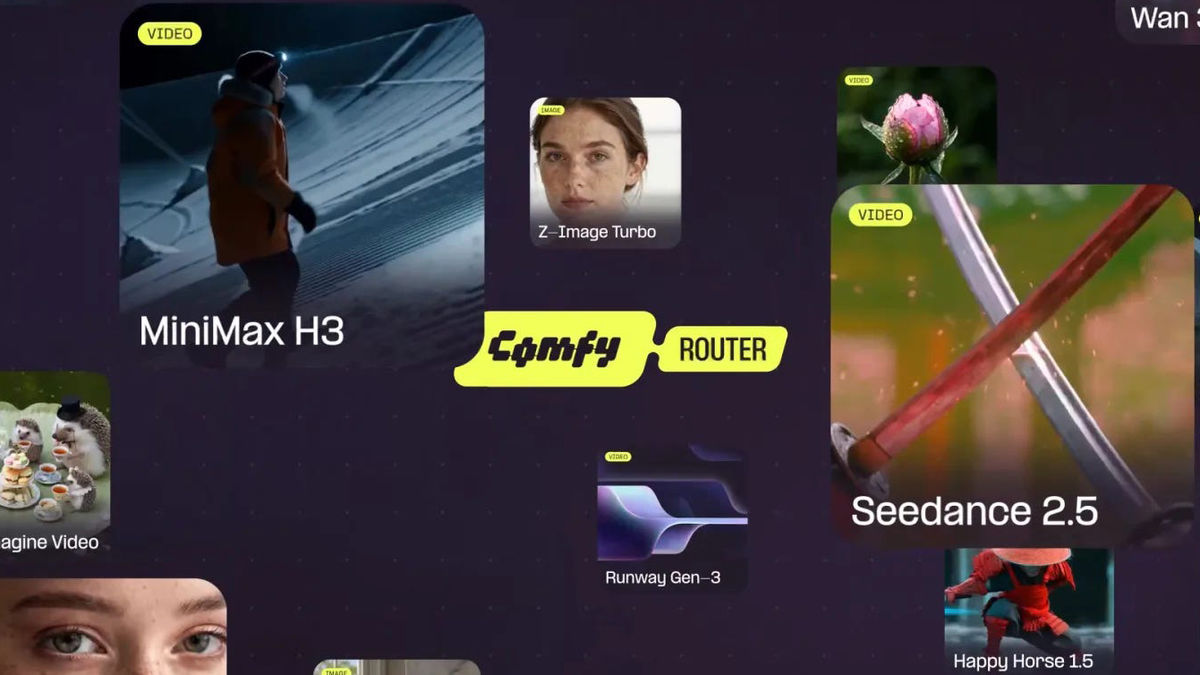
ローカル画像・動画生成アプリComfyUIの開発元Comfyが2026年9月23日、複数のAI生成APIをまとめて扱えるComfy Routerをリリース
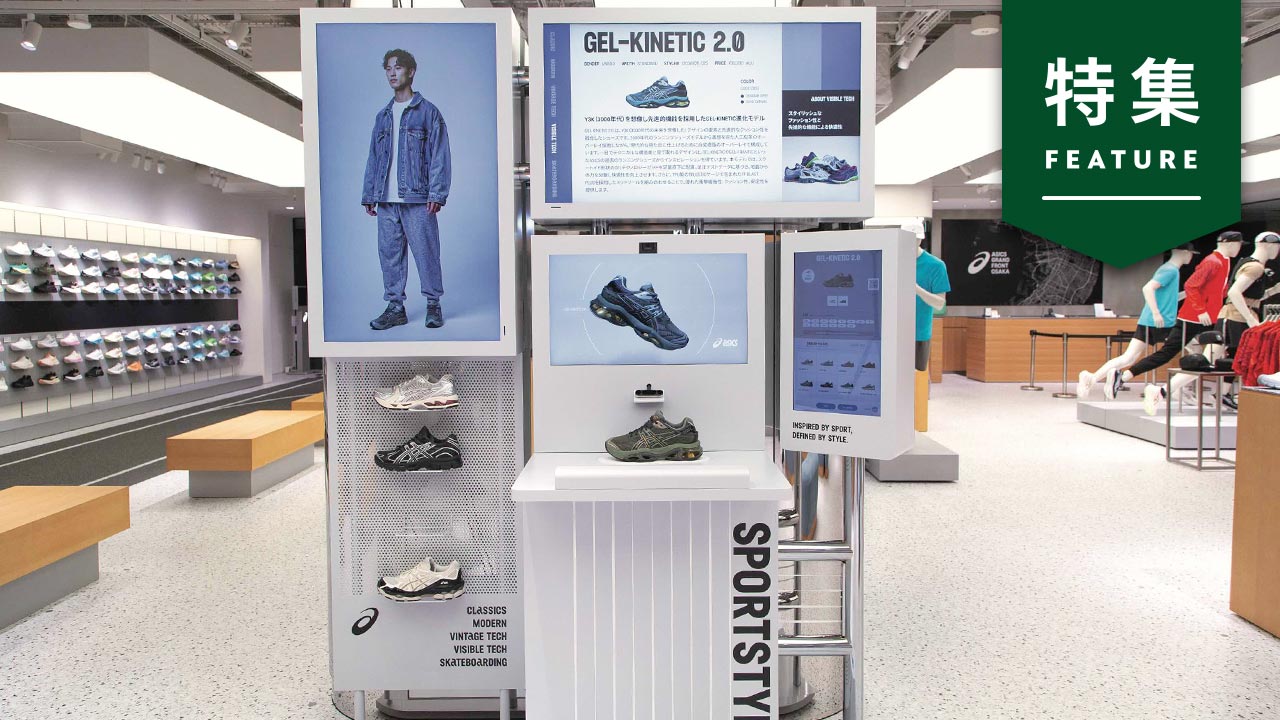
アシックスが生成AIで全商品の着装イメージ画像を生成する仕組みを構築し、撮影やモデルなしでコストを大幅に削減した
割安株スクリーニングでAdobe(ADBE)とBroadcom(AVGO)がAI関連銘柄として浮上し、Adobeの生成AIクレジット利用がARPU拡大の要因と指摘された
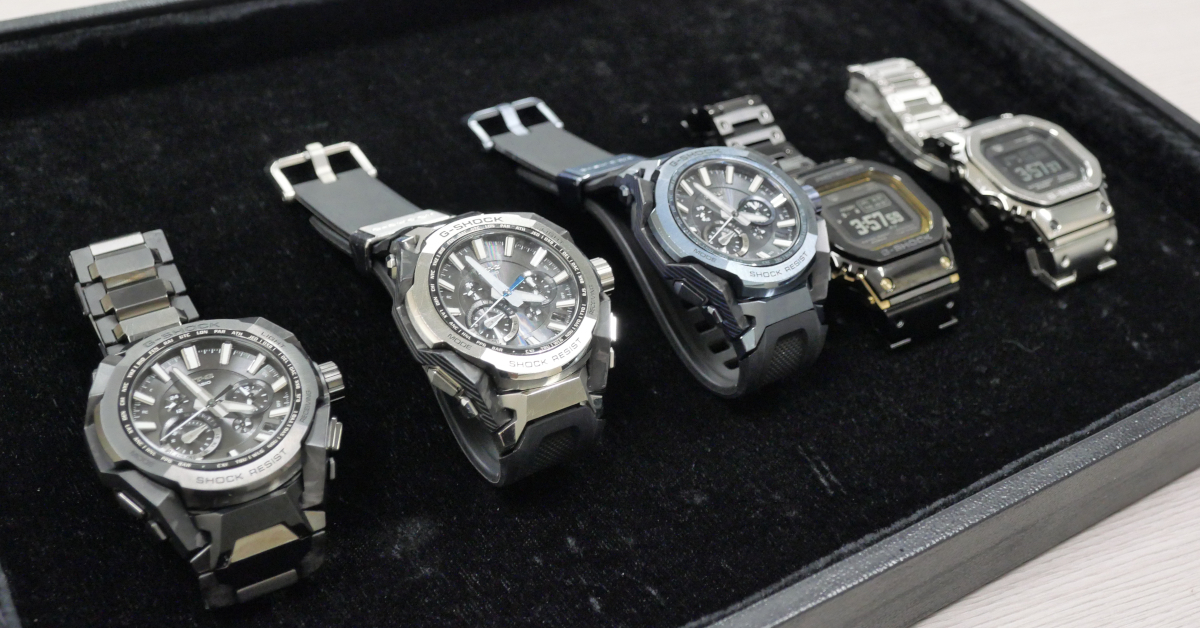
CasioのG-SHOCKチームがAI画像生成と自社デザイナーを組み合わせ、時計のコンセプトを製品化可能な製品に発展させた
AIニュースを、今日の仕事につなげる。
100以上のソースから、その日の要点だけをEmail・LINE・Slackへ。無料で始められます。
月間読者 60,000+Appleの研究者がprobe guidanceを発表
OracleがOracle AI Agent Memoryの新機能を発表
InvideoのCEO Sanket Shah氏によると、GPT‑6 Astraはカラーグレーディングとカラーコレクションの成功率を約3倍にし、編集者が1日で約50個のカスタムエフェクトを作成した
AlibabaのQwen AIチームがオープンウェイトモデルQwen-Image-2.1を公開
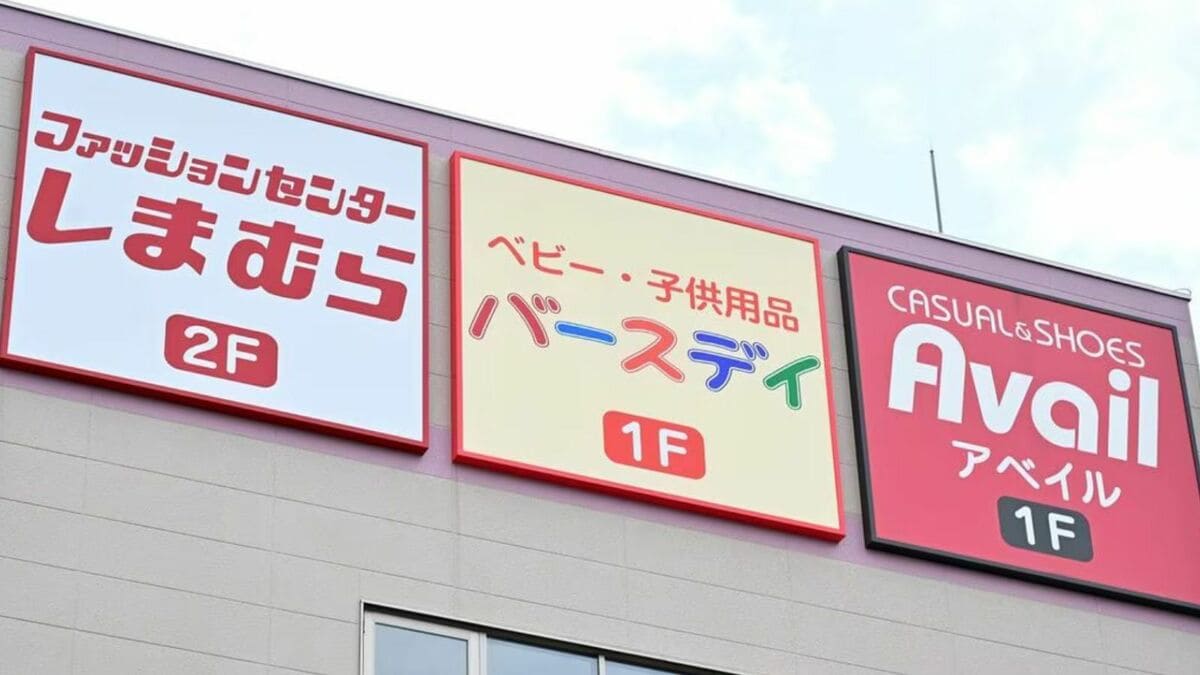
しまむら系のベビーブランド「バースデイ」が生成AI広告をめぐり批判殺到
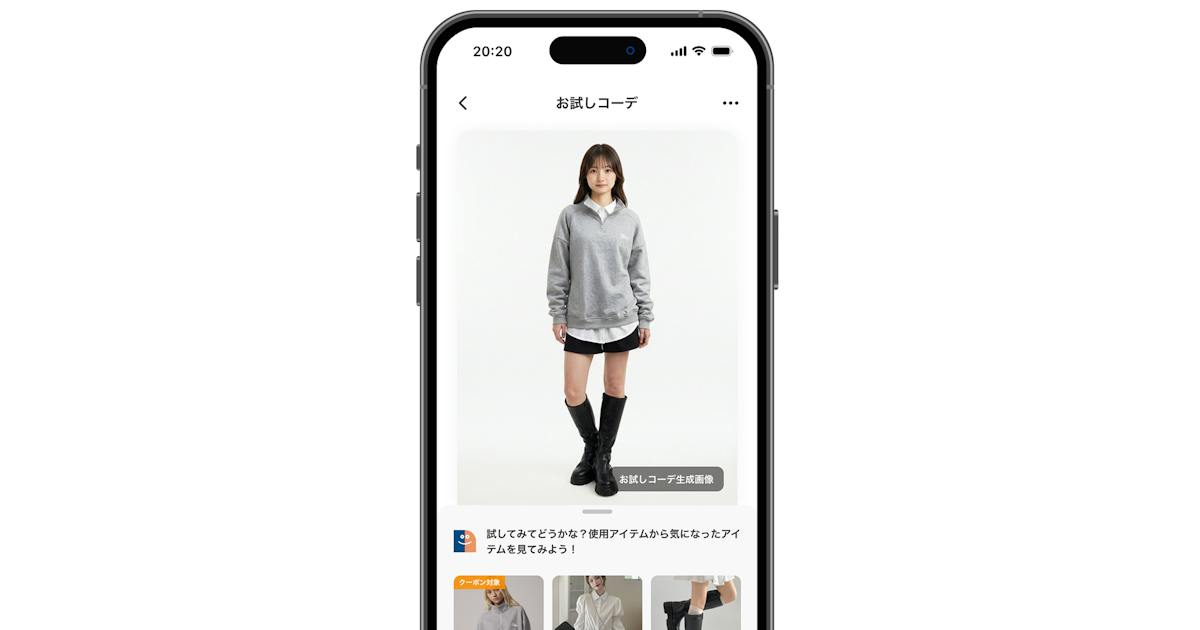
ZOZOはコーデ投稿アプリWEARで、好みの写真をもとに28種から「ファッションコア」を診断し、1500万件超の投稿から着こなしを提案する機能を追加した
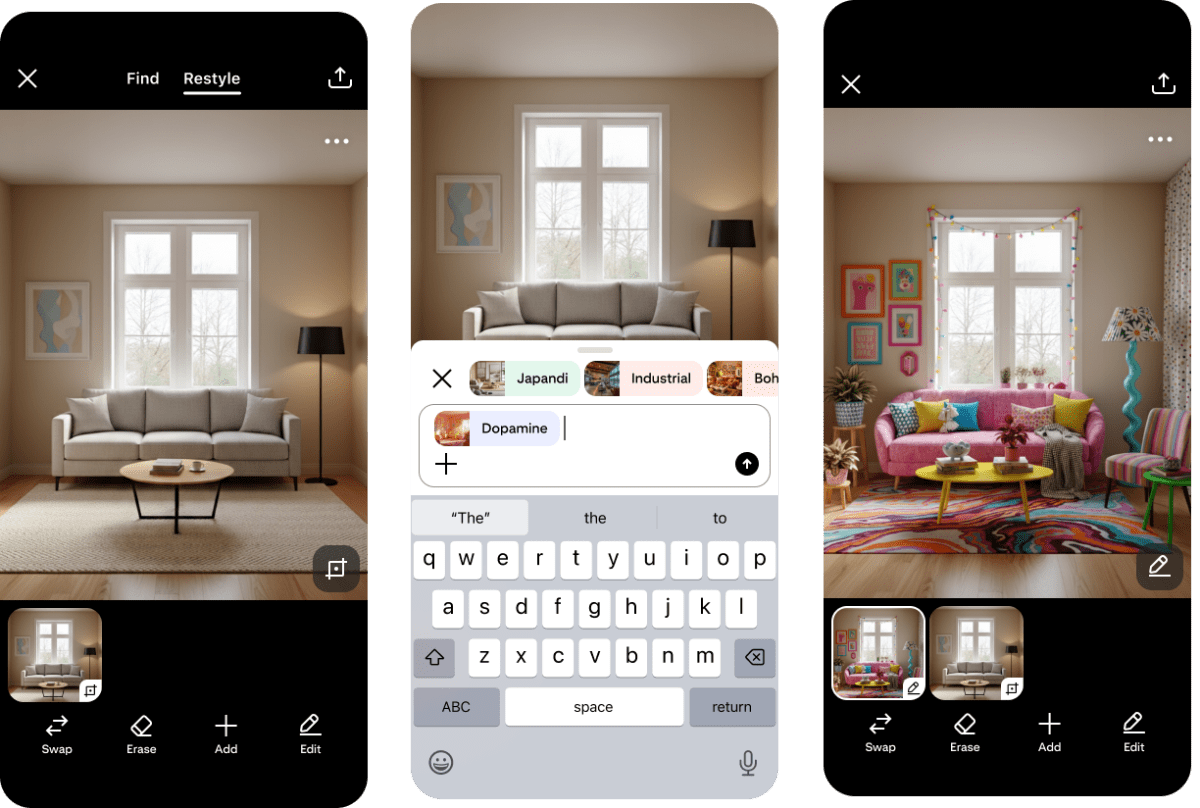
Pinterestは木曜日、新機能「Restyle」を米国とカナダでベータ版として公開すると発表した
九州国立博物館は9月17日、特別展「卑弥呼の鏡」のポスターとチラシのイラストの一部に生成AIを使用したと発表した
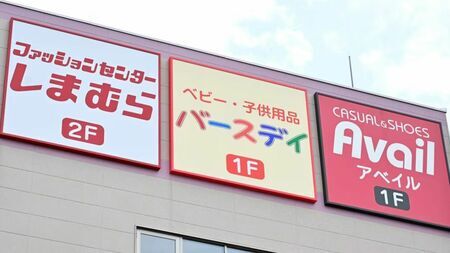
しまむらの子供服ブランド「バースデイ」が生成AIで作った広告を展開し、子供の顔が皆同じで気味が悪い、安っぽいといった批判が殺到した
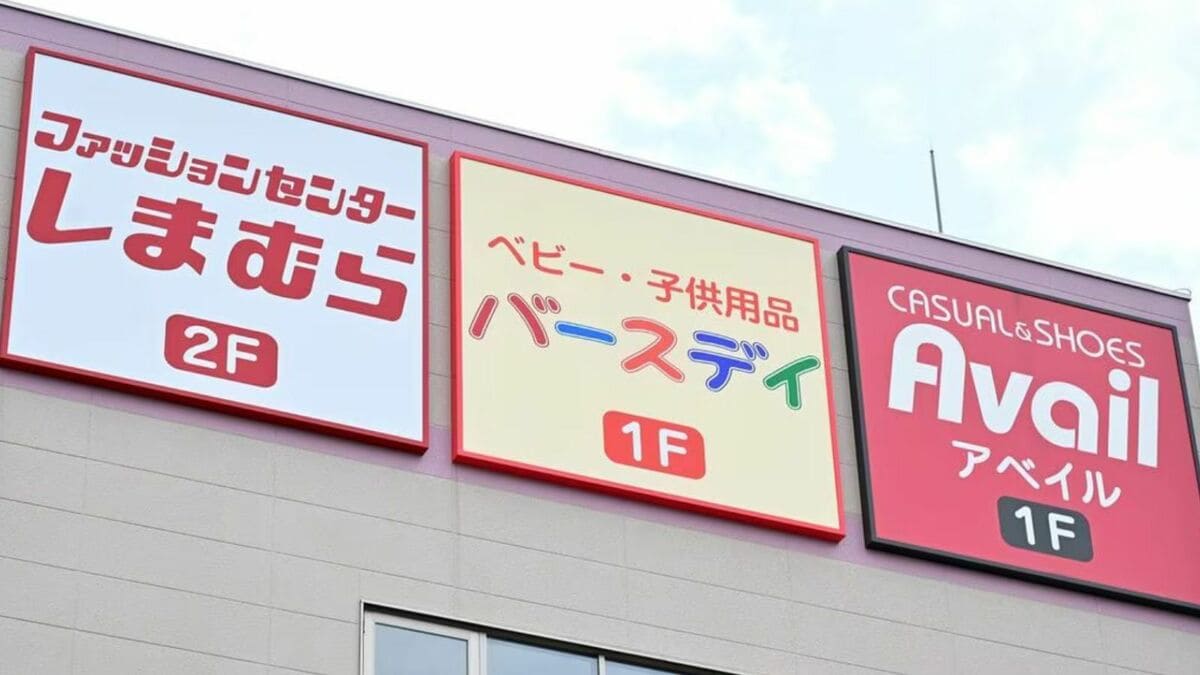
しまむら系の子供服ブランド「バースデイ」が、生成AIの広告を巡りネット上で批判の波に直面
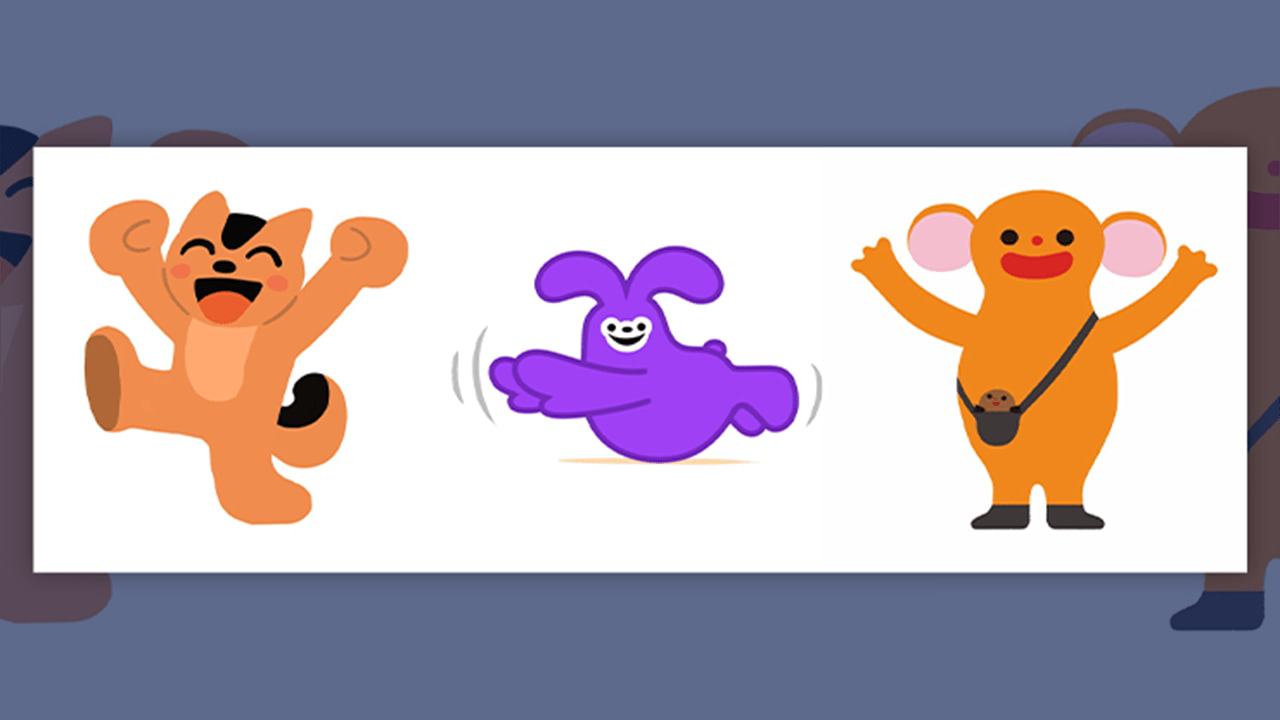
JR東日本は9月8日、Suicaのペンギンの後継候補3体——リス、ウサギ、オレンジ色の袋に入ったモグラのキャラクター——を発表し、9月23日までの投票を開始した
元TikTok社員のMelody Chu氏とJing Liu氏が、自撮りや写真からAIで4つのポーズを生成するiOSアプリSuperposeを始動し、Khosla Ventures、Meitu、OVTR VCから220万…
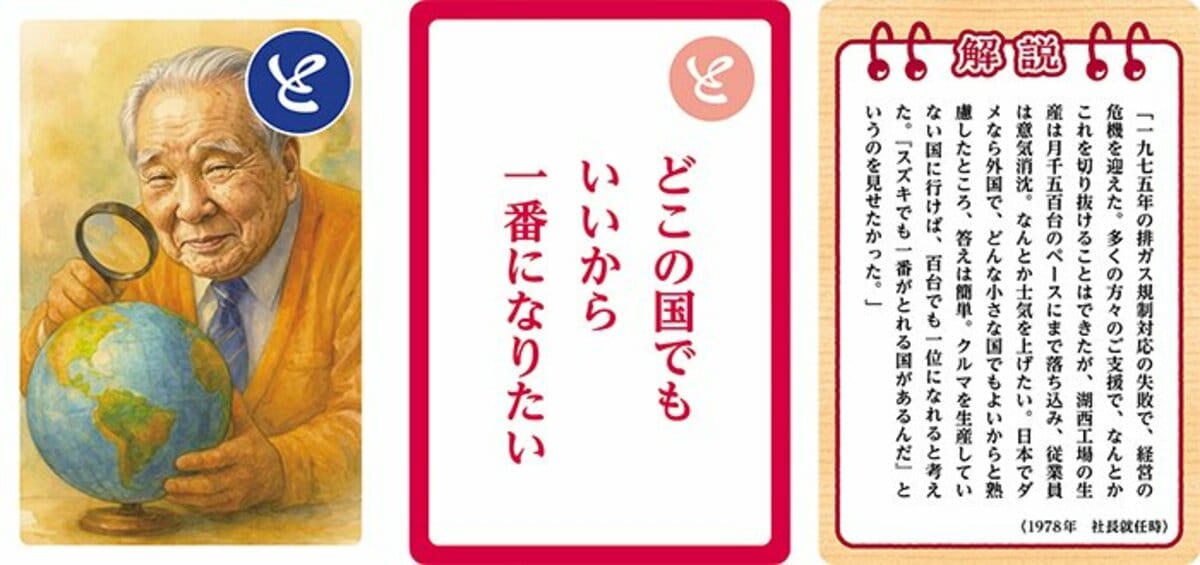
スズキの故・鈴木修会長の語録がかるたになった
OpenAIが、Ziv Attar氏とTom Bishop氏が2019年創業のGlass Imagingを、The Wall Street Journalによると3億ドル超で買収した
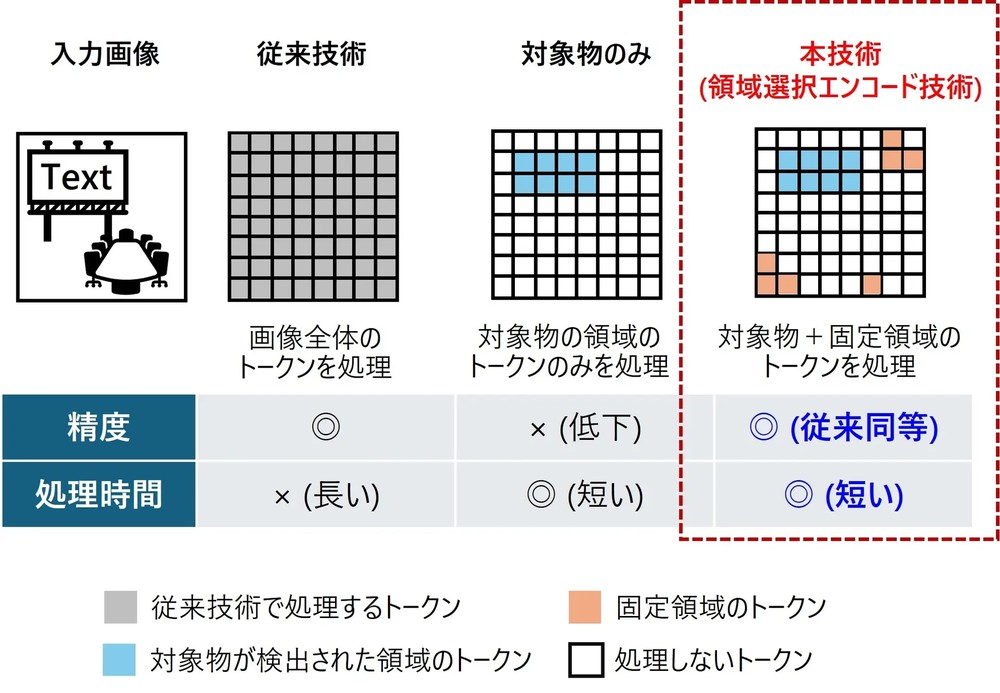
日立は2026年8月25日、AI解析における画像データの平均処理時間を精度を維持したまま半減させる選択的再符号化技術を発表した
AWSはTwelveLabs Marengo Embed 3.0をAmazon Bedrock Knowledge Basesの埋め込みモデルとして一般提供開始

アップルは「Surprise and Shine」イベントでApple Reference Imageを発表

インタビューでアドビ幹部が、生成AI時代におけるPhotoshopの役割と「プロ」とみなされる条件について語った

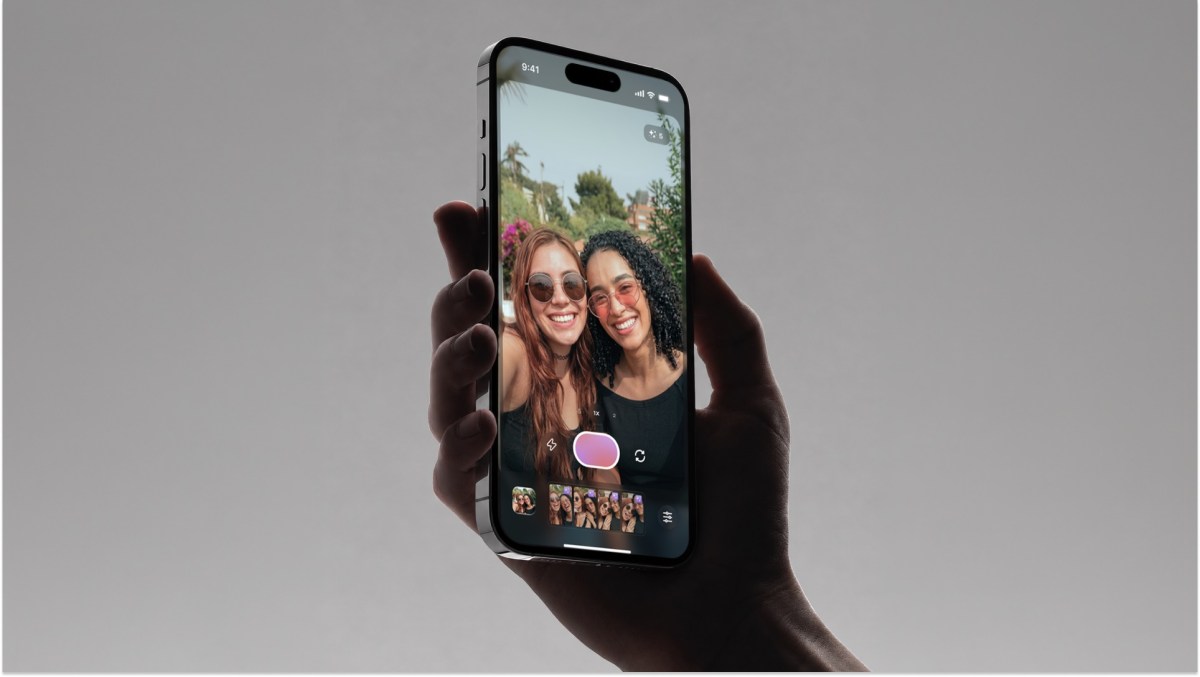
Appleの新機能「Reference Image」が今月後半、iPhone 18 Proシリーズに搭載され、カメラセンサーが「見たピクセルすべてに署名」する

Google DeepMindとPrimordial Soupがリズ・ガーバス監督の短編ドキュメンタリー『Love, Rendered』を制作

OpenAIは4月に登場したChatGPT Images 2.0のアップデート版、ChatGPT Images 2.5を発表した
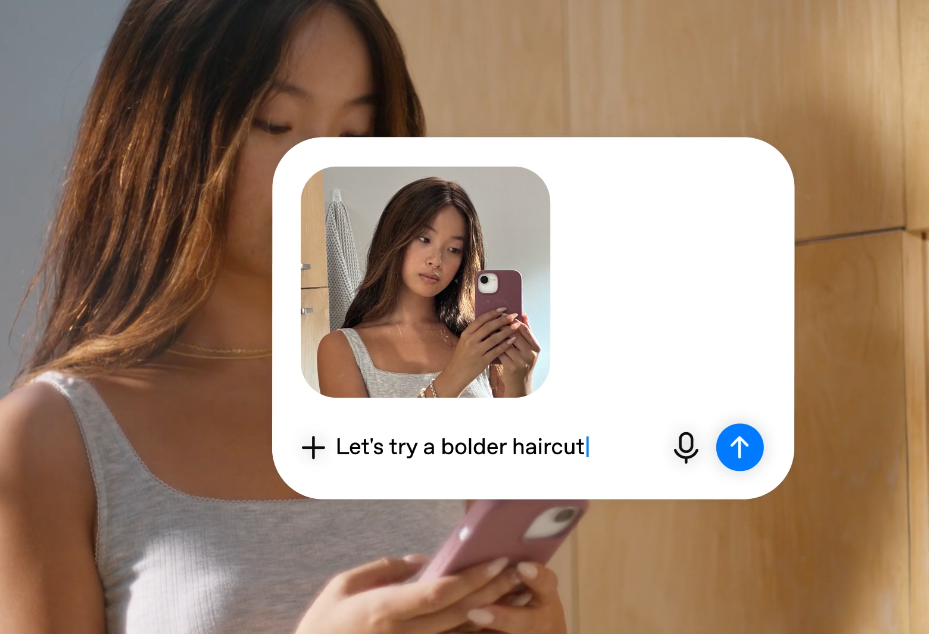
ITmedia Newsが、広報のプロの視点から、AI生成画像に消費者が抱く違和感の理由を解説する記事を公開
OpenAIがChatGPT Images 2.5と新機能Sketchを発表
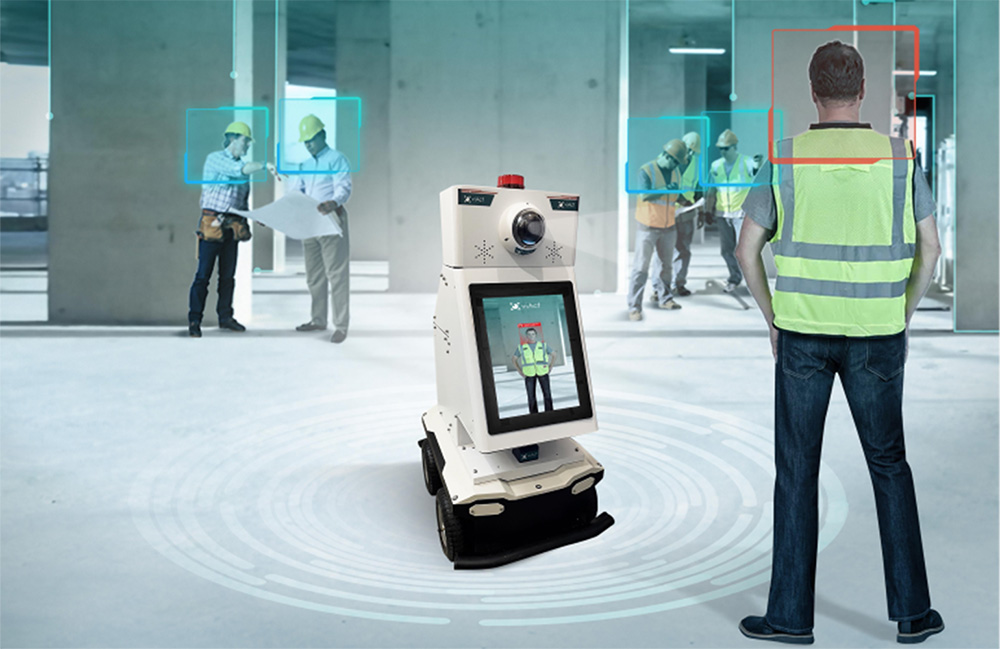
建設現場の安全対策として視覚AIが普及しつつある
OpenAIが新画像生成モデルChatGPT Images 2.5を発表した
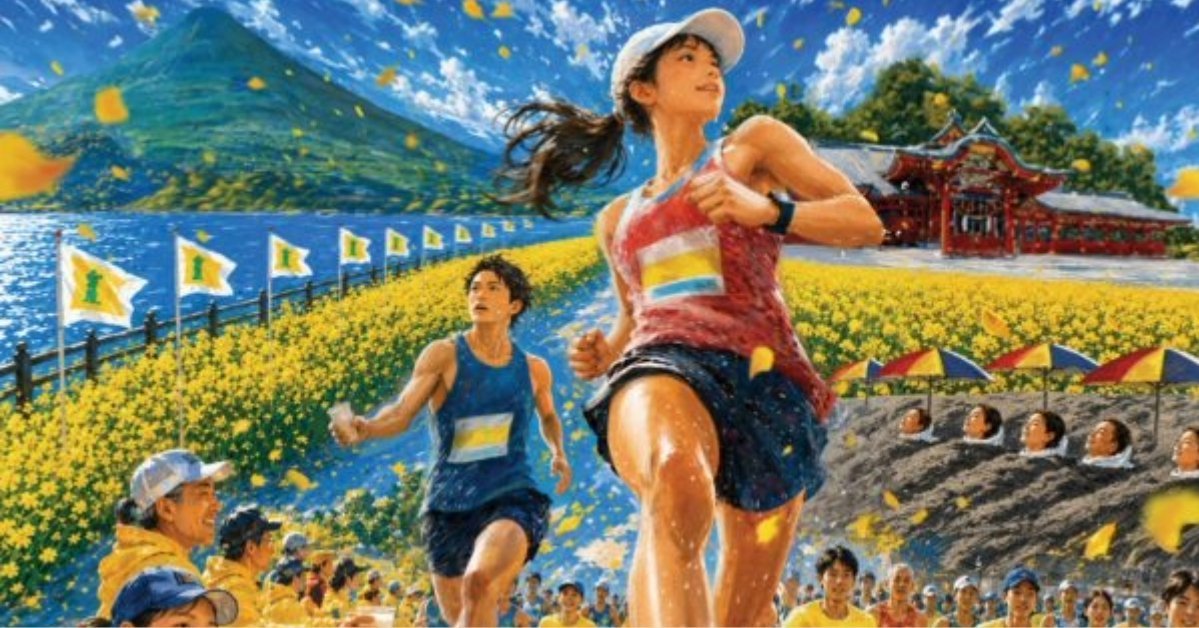
鹿児島県指宿市の指宿マラソン事務局は9月8日、ポスターに生成AIを使用したと認めた
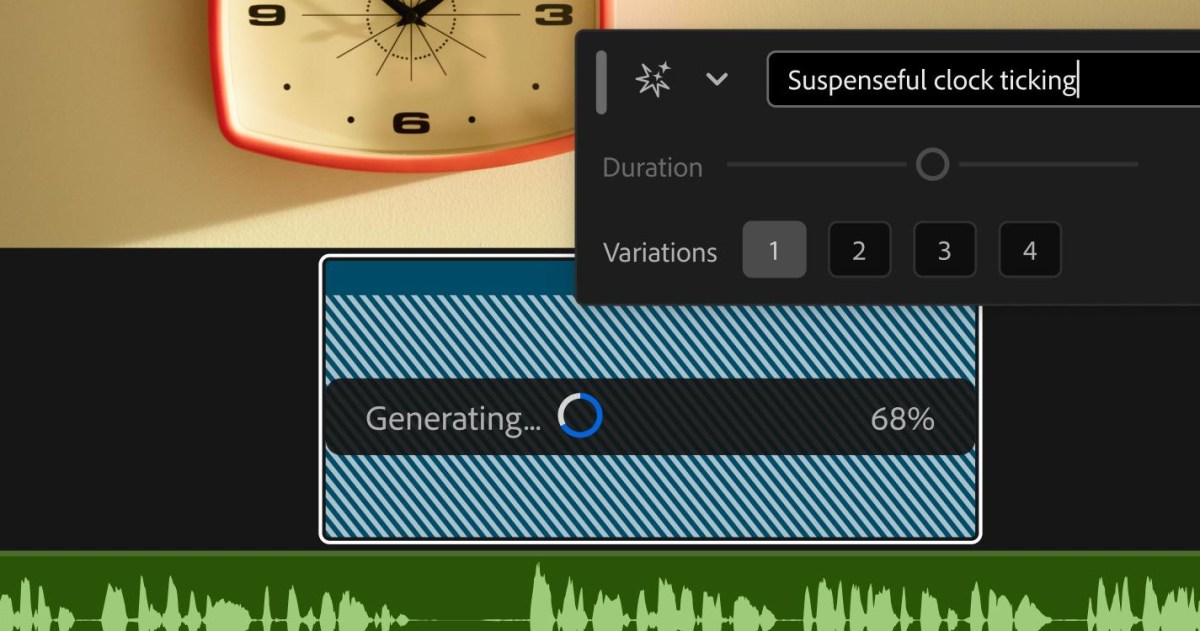
AdobeがPremiereにGenerative Mediaを導入
レストランが実物の料理を撮影する代わりに生成AIで食品広告を作る事例がニューヨークやサンフランシスコで出ており、ネットで批判が殺到
レストランやカフェ、ブランドがAIで料理画像を生成するケースが増えているが、結果は「スロップ」と呼ばれる出来になることも——例えばドーナツ型のエビ、ミミズのような麺、コンクリートを思わせるアイスクリームなどだ
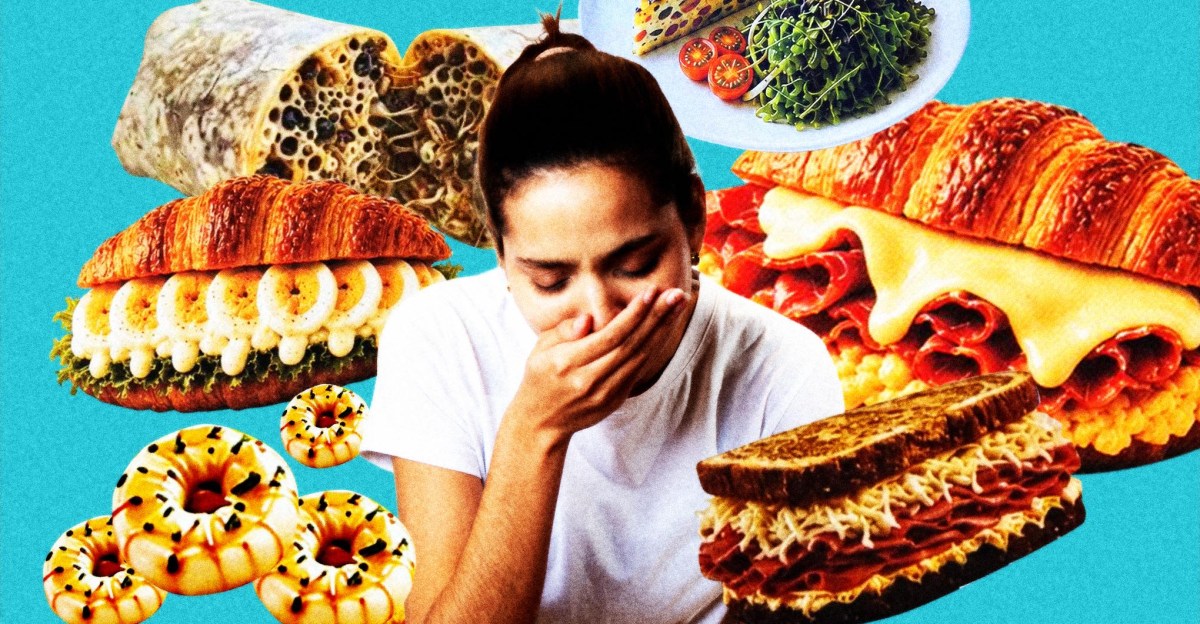
レストランのAI生成メニューは、完璧すぎるほど対称的で滑らかな食品を映し出し、客に違和感を与えることが多い
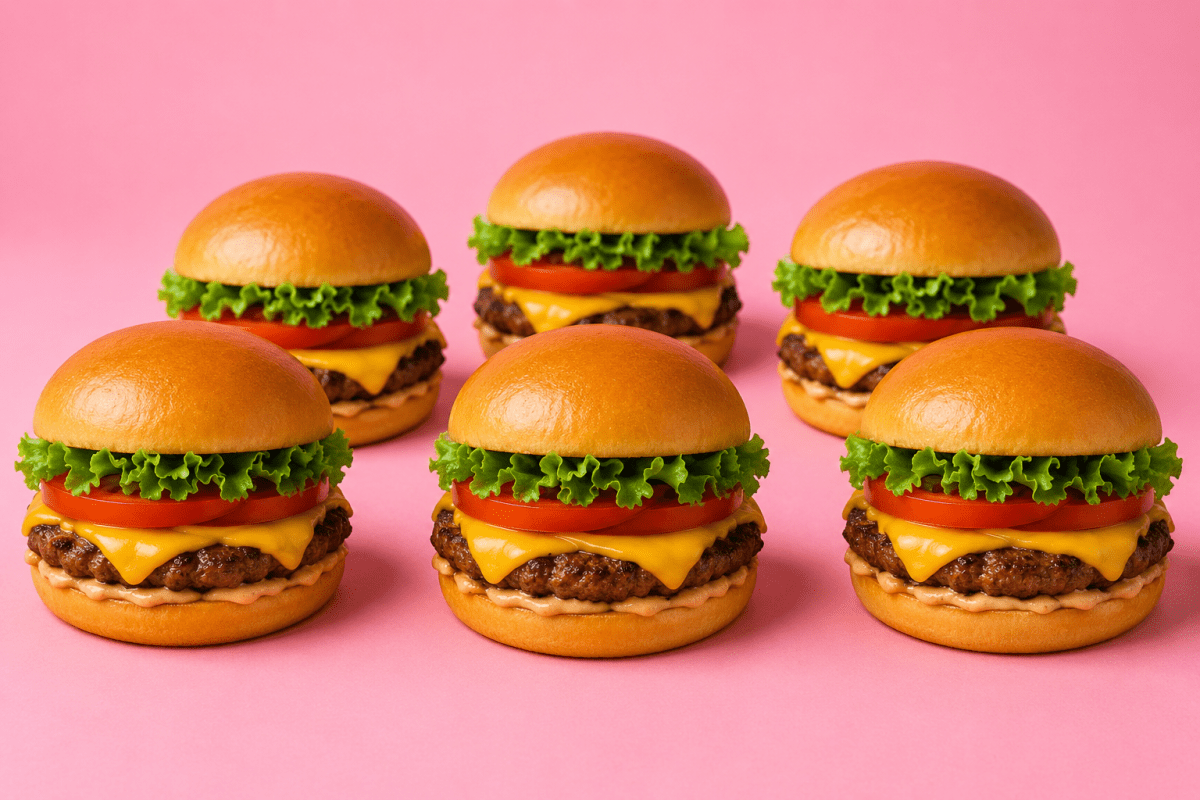
ITmediaの記事が、消費者がAI生成画像を「不気味」と感じる理由を解説
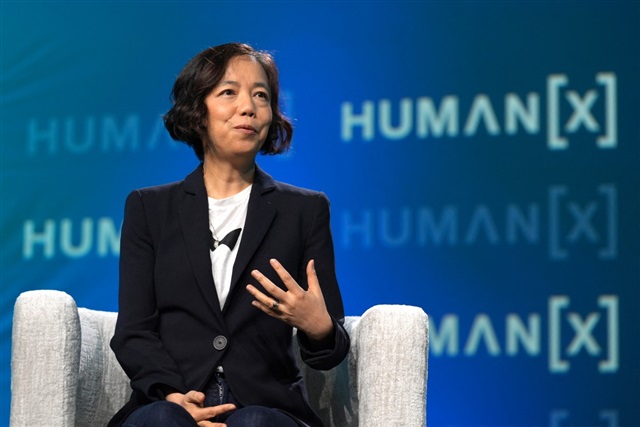
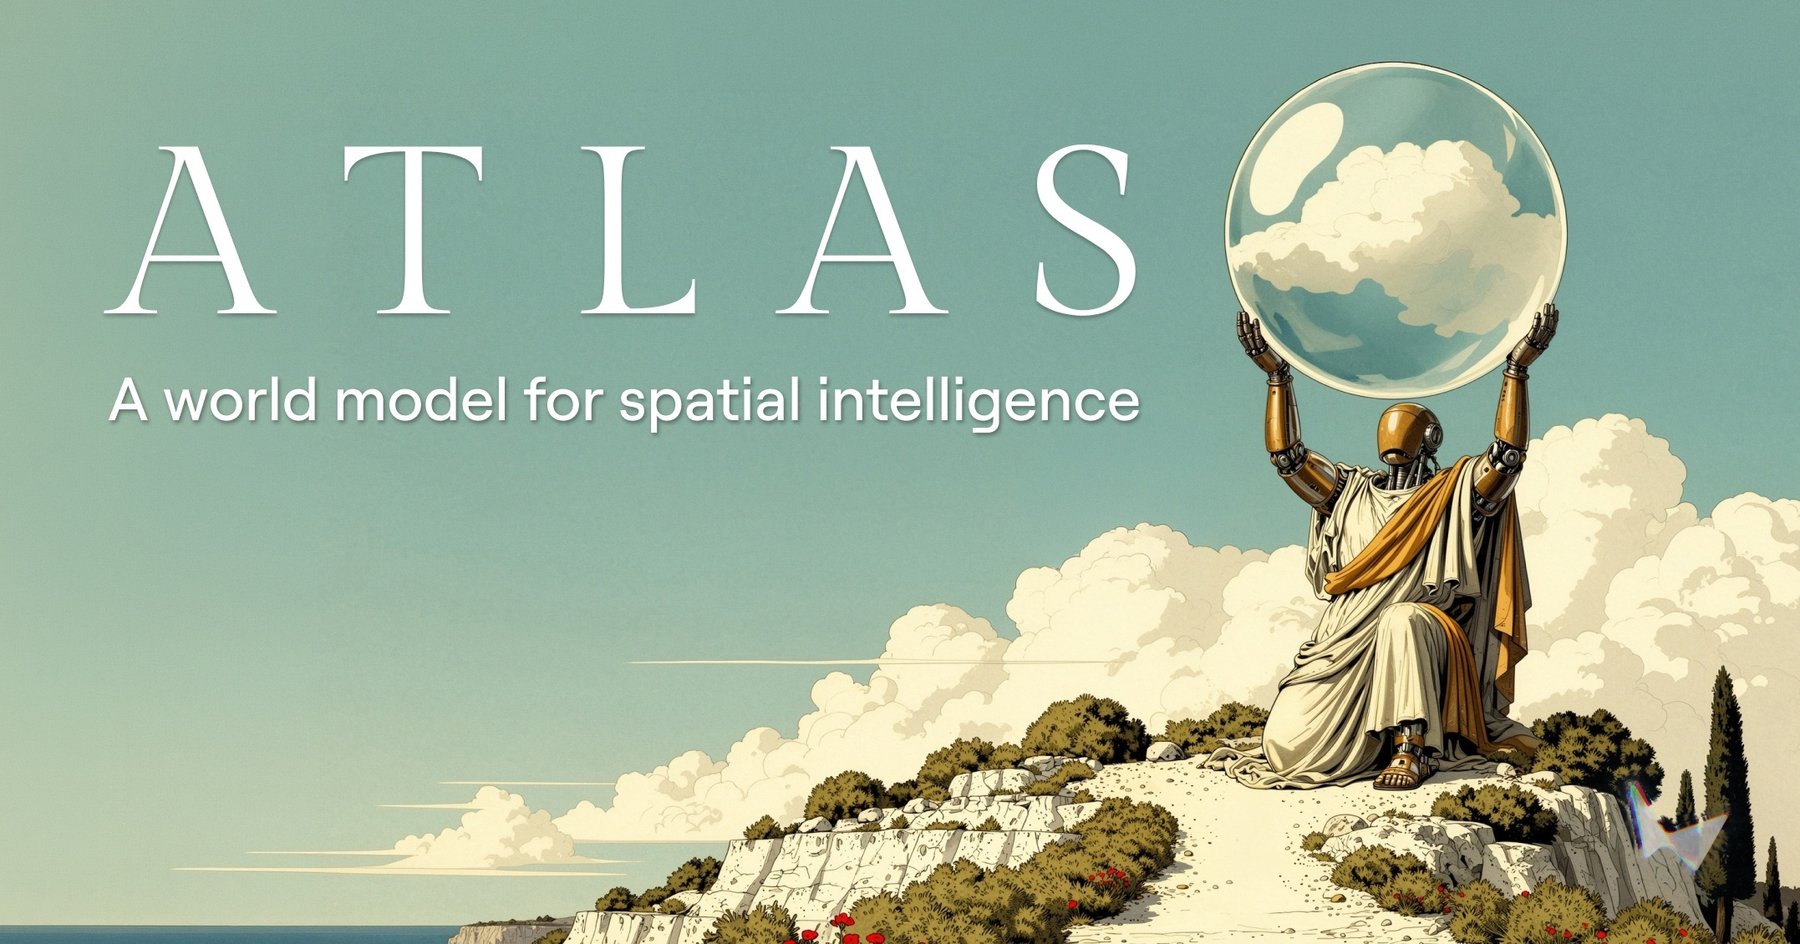
スタンフォード大教授の李飛飛氏が設立したWorld Labsは、テキスト・画像・動画から3D環境を生成・再構築・シミュレーションできるマルチモーダル世界モデル「Atlas」を発表した
Jasper Researchが、テキスト画像生成モデルをゼロから構築する方法を解説する料理本を公開し、全推論プロセスと途中結果を共有した
AWSチームがAI搭載のコンテンツ検証システムを構築し、AWS Insightsアプリケーション(Amazon Quickに搭載)の数百のダッシュボードをスキャンして、欠落や誤った要素を検出する
World Labsが、テキスト・画像・動画・3Dデータで学習し、各入力を3D空間内の特定位置に紐付けるオムニモデル「Atlas」を発表
Fei-Fei Li氏が共同創業したAIスタートアップWorld Labsが、1枚の2D画像から詳細な3Dシミュレーション環境を作り出すマルチモーダル世界モデル「Atlas」を公開した
100以上のソースから厳選したAIニュースを毎日無料でお届けします。
月間読者 60,000+
無料で始める登録無料・Googleアカウントなら30秒・いつでも解除できます