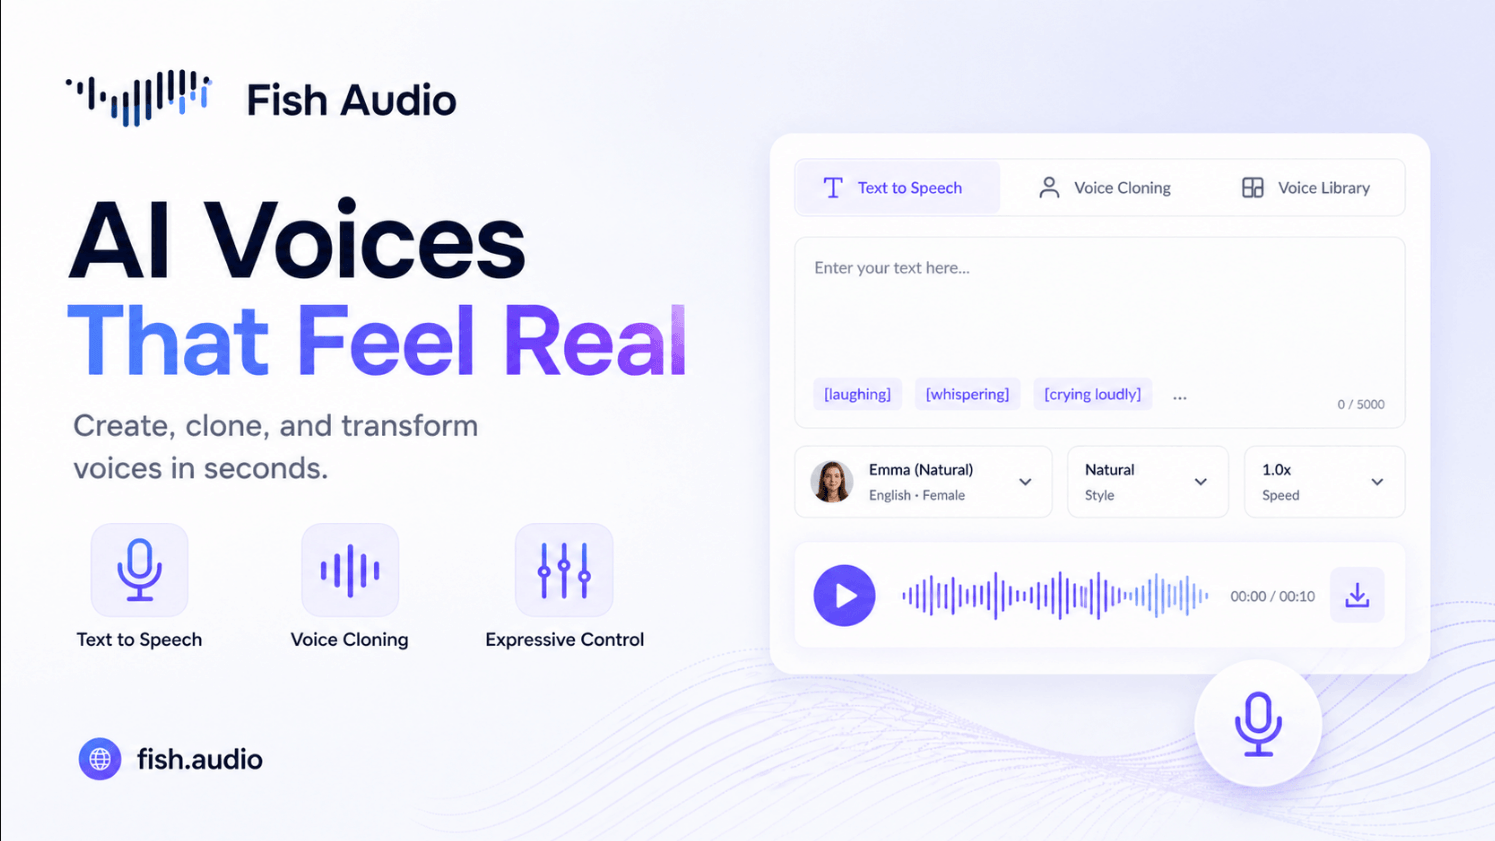
元Nvidia研究員の廖世嘉が創業したAIスタートアップFish Audioが、Coreline VenturesとCapital Todayが主導するシードラウンドで5200万ドルを調達した
Googleが音楽生成モデル「Lyria 3.5」をリリースした
OpenAIがAPI経由で音声認識モデルGPT TranscribeとGPT Live Transcribeを公開した

OpenAIは音声をテキストに変換する新モデル「GPT-transcribe」と「GPT-live-transcribe」を発表した
パロアルト拠点のFish Audioは、ユーザー数800万人超、年間経常収益2100万ドルを生み出している企業で、火曜日にCoreline VenturesとCapital Todayが主導するシードラウンドで5200万…
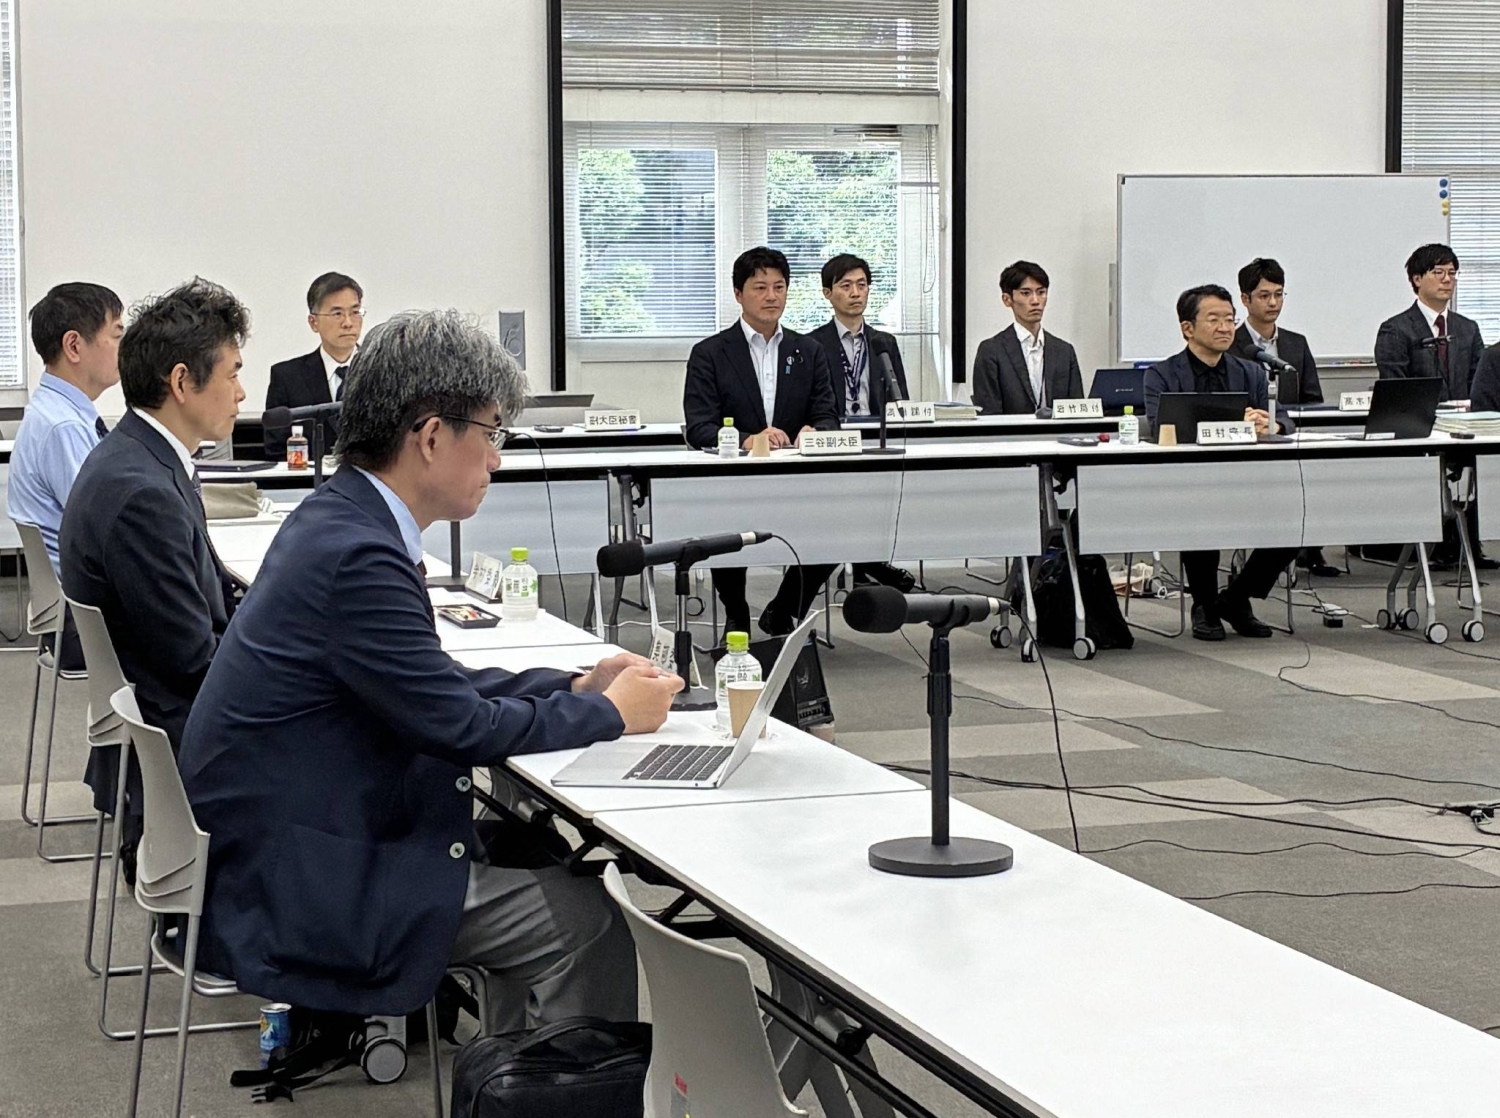
日本の法務省の専門家委員会が月曜日、生成AIを用いた著名人の音声の無断使用について、有名人が自らのアイデンティティの商業的価値を管理できる法的保護である肖像権に基づいて民事責任を問えると定めた答申案を承認した
ポッドキャスト検索データベースのListen Notesが、新たに作成されたポッドキャストの30%以上が人間制作ではなくAI生成音声で構成されていると報告した
Deepgram は AWS IAM の新機能である一時委譲を、Amazon SageMaker AI 上で Deepgram の音声AI モデルを実行する顧客向けのサポートワークフローに統合しました
Amazonの元Distinguished Scientistアレックス・スモーラ氏がBoson AIを設立し、競合他社の音声システムよりも大幅に低価格な音声間翻訳モデル「Higgs RealTime」をリリースする
開発者がARIA(音声制御型セキュリティオペレーションコックピット)をリリースした
OpenAIは木曜日にChatGPTデスクトップアプリをアップデートし、ChatGPT Voiceに対応させた
Anthropicが音声モード対応を、それまでのHaikuに限定されていたOpusとSonnetモデルに拡張した
OpenAIがデスクトップおよびノートパソコン向けにChatGPT Voiceをリリースした
Skipperはインターネット接続なしで動作するAIコンパニオン
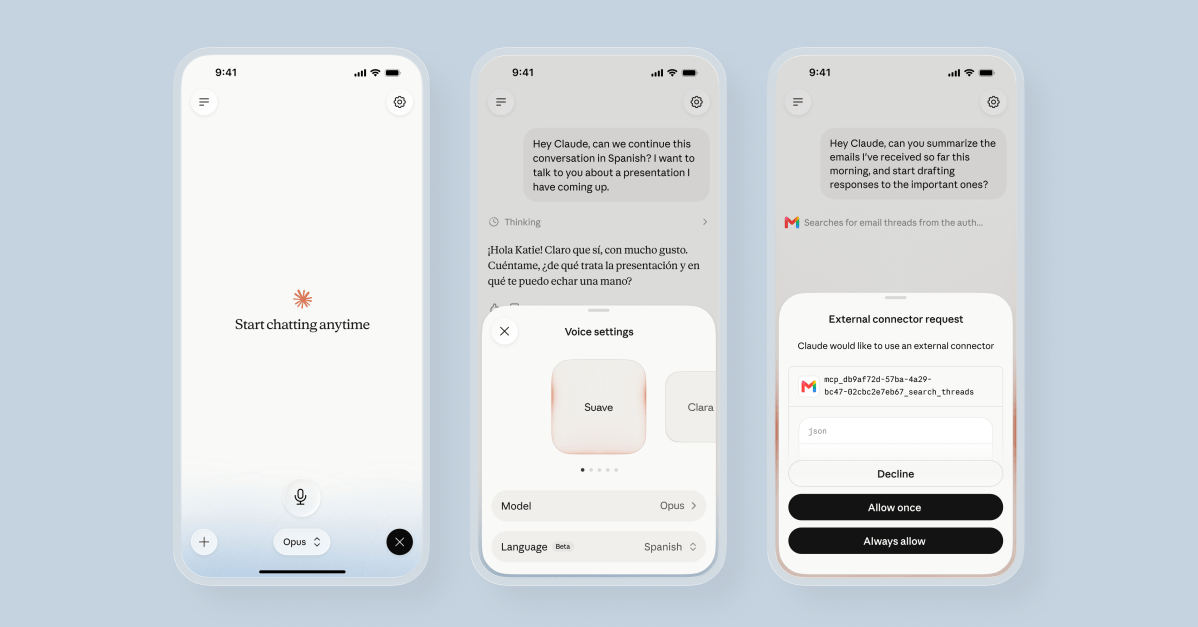
AnthropicがClaudeの音声モード機能をOpusとSonnetモデルに拡大し、Gmail、Slack、Canvaなどのアプリにも対応させました
Anthropicが音声モードをアップデートし、ユーザーがOpus、Sonnet、Haikuから選択できるようにしました
ドイツのAI企業Black Forest Labs(BFL)が、画像・動画・音声を統合学習するマルチモーダル基盤モデル「Flux 3」を発表しました
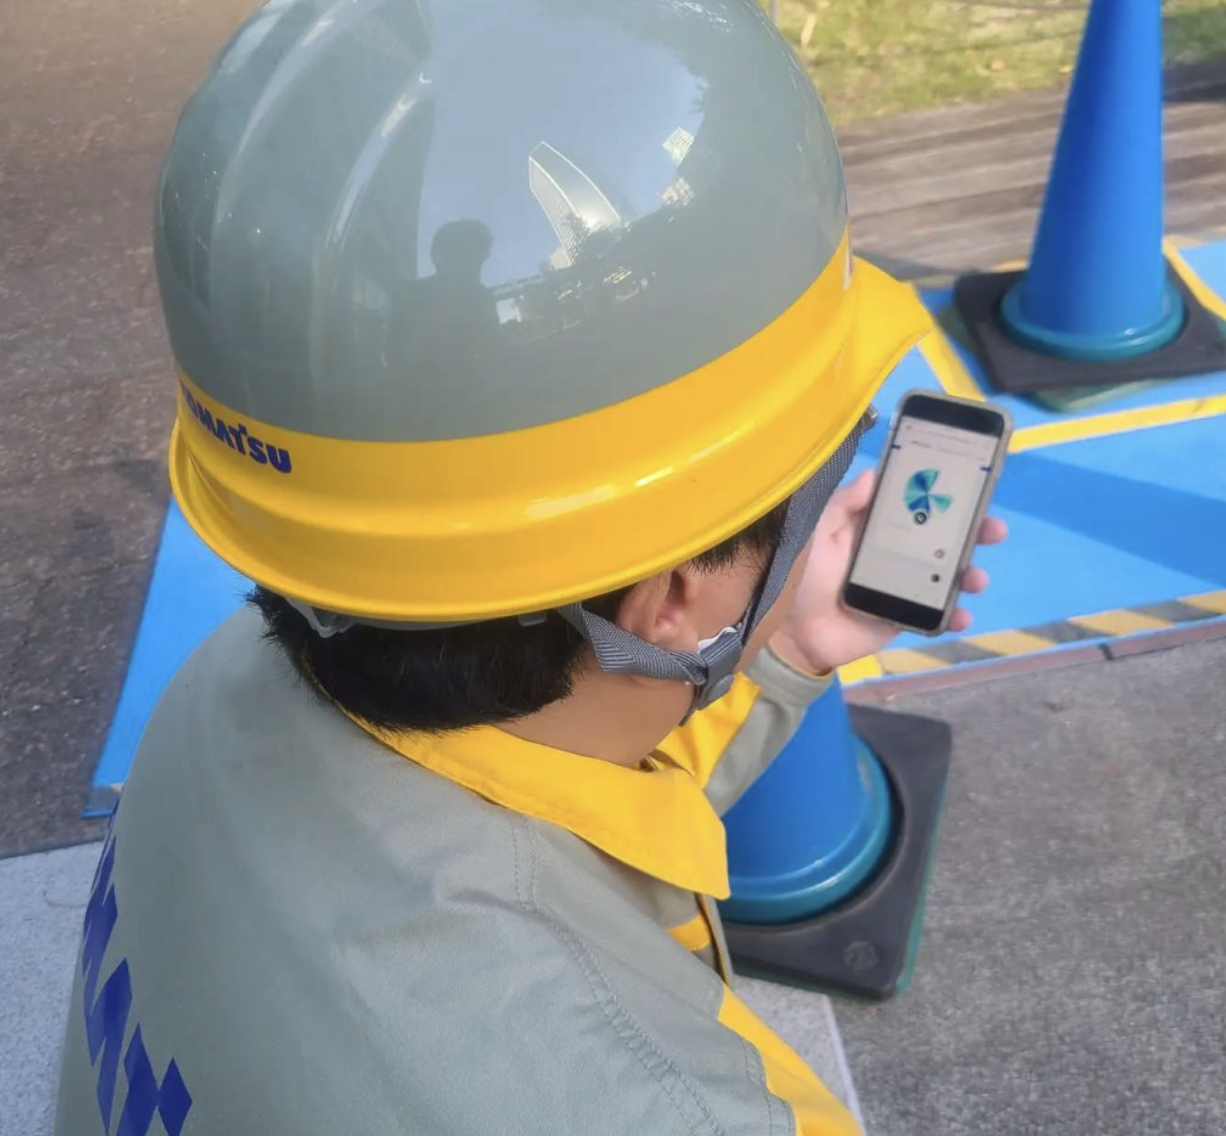
SORABITOとEleventh Labsは、「アームの動きが鈍い」といった口頭での説明から設備の故障を診断する対話型音声AIシステムを開発した
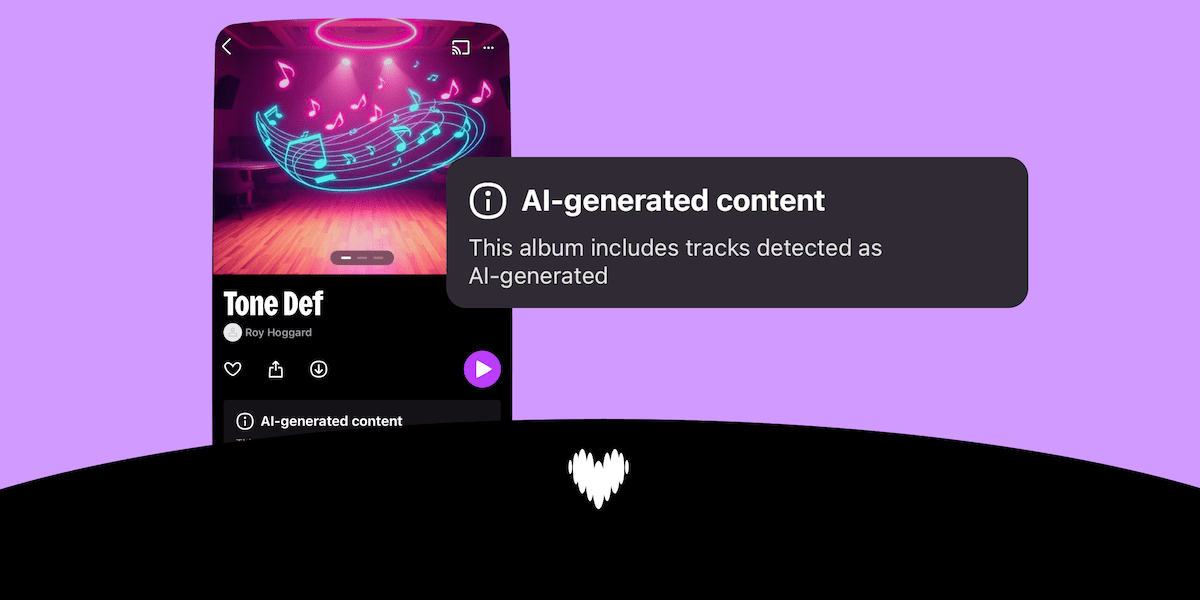
音楽ストリーミングプラットフォームの Deezer は、AI生成音楽が同サービスの日次アップロードの50%以上を占めるようになったと発表した
Sony Music Entertainment は月曜日、AI音楽生成ツール Udio を相手に、Beyoncé、Britney Spears、Elvis Presley、Harry Styles ら著作の3万曲以上の…
アーティスト1010Benjaは最新EPで「Semiramis' Dream」という楽曲をSunoの生成AIを使って制作したが、従来の使い方とは異なり、歌詞を自分で書き、自らボーカルを録音し、プロデューサーとビート制作で…
AI音楽生成ツールのSunoがYouTube Music、Deezer、Genius、Pond5、Jamendo、Freesound、International Music Score Library Project(I…
AI音楽生成サービスのSunoが2025年11月にハッキング被害を受けました
Telnyx は、Telnyx Call Control と Llama 3.3 70B AI を使用したオープンソース Python アプリケーション(102行)をリリースした

AWS Partner の ScienceSoft が、Amazon Nova Sonic と Amazon Bedrock Guardrails を活用し、HIPAA準拠のAI音声予約アシスタントを構築しました
AppleがiOS 27をパブリックベータとしてリリースし、刷新された「Siri AI」をiPhoneユーザーに初めて提供した
パリ拠点の音声AIスタートアップGradiumが、Nvidiaを含む新たな投資家を加えてシード資金調達を再開し、総額$100 million(約160億円)を調達しました
OpenAIが新型音声モデル「GPT-Live-1」を発表しました
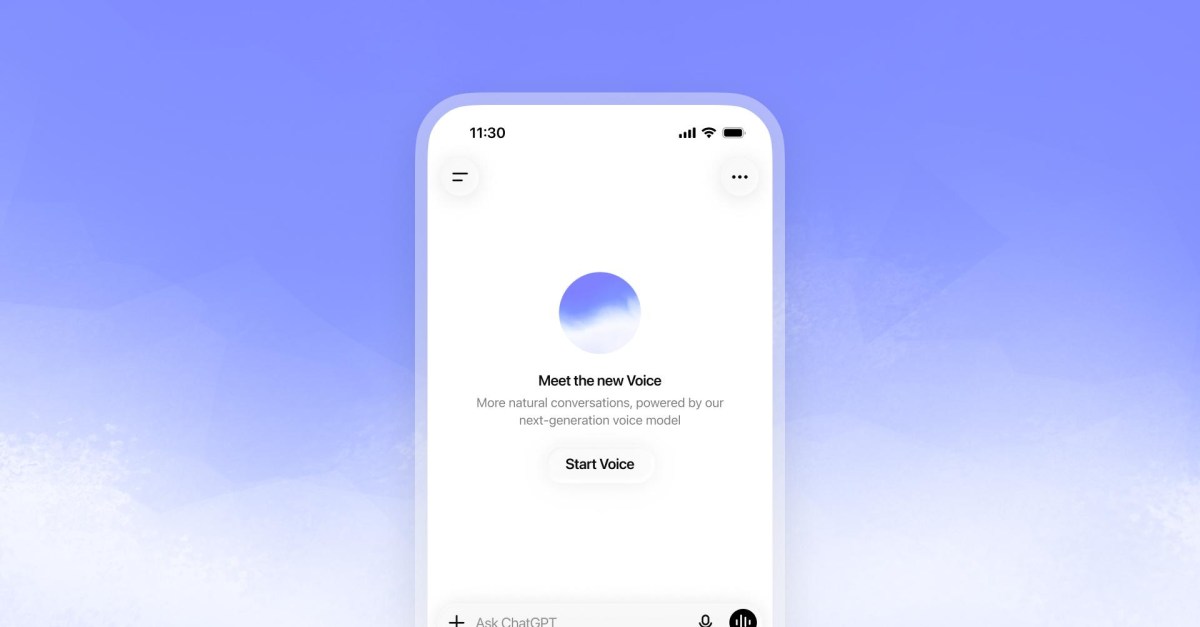
OpenAIが新たな会話型音声モデルGPT-Live-1とGPT-Live-1 miniを発表しました
Cohereが「Cohere Transcribe Arabic」という20億パラメータのオープンソース音声認識モデルを公開しました
屋根修理・外装サービスの大手Vertex Service Partnersが、AI音声・SMS対応プラットフォーム「Revin」を全国27の地域ブランドで導入しました

Hugging FaceとCerebasが、音声認識・言語モデル・音声合成を組み合わせたリアルタイム音声対話システムのデモを発表しました
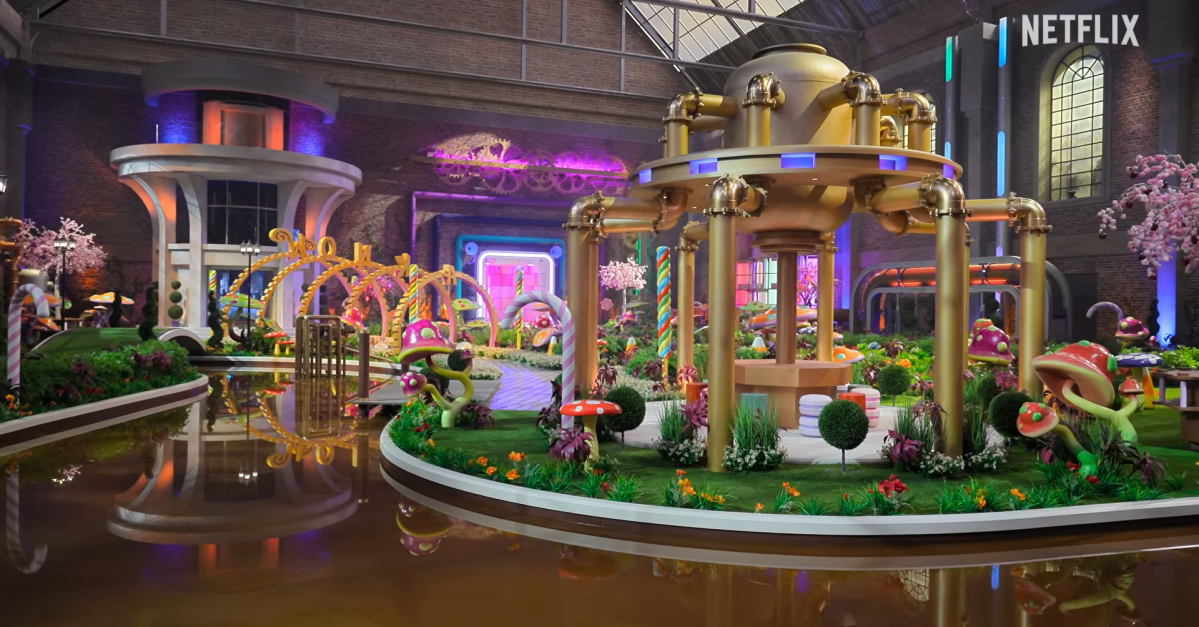
Netflixが「Wonka's The Golden Ticket」という実写競技番組を制作し、ナレーションにAI音声生成企業ElevenLabsと協力してジーン・ワイルダーのAI生成音声を使用しています
Winamp Group傘下のJamendoがSuno, Inc.を相手に米マサチューセッツ州の連邦裁判所に訴状を提出しました
AIニュースを、今日の仕事につなげる。
100以上のソースから、その日の要点だけをEmail・LINE・Slackへ。無料で始められます。
月間読者 60,000+AI Voice Studioというツールが提供開始され、ユーザーはスクリプトを入力するだけで70以上の言語でナレーションを生成できます

GoogleがGemini 3.5 Live Translateをリリース

ElevenLabs は英国科学イノベーション技術省(DSIT)と覚書を締結し、音声AIを公共サービスに活用する方法の探索、AI セキュリティ研究の深化、英国の音声・オーディオAI人材ハブとしての地位強化に協力する

AppleはWWDCで「Siri AI」を発表

Audio-Interactionは3billion parameterの単一モデルで、音声ストリームを連続監視し、0.4秒単位で<silent>または<response>トークンを出力して、発話か沈黙かを決定する
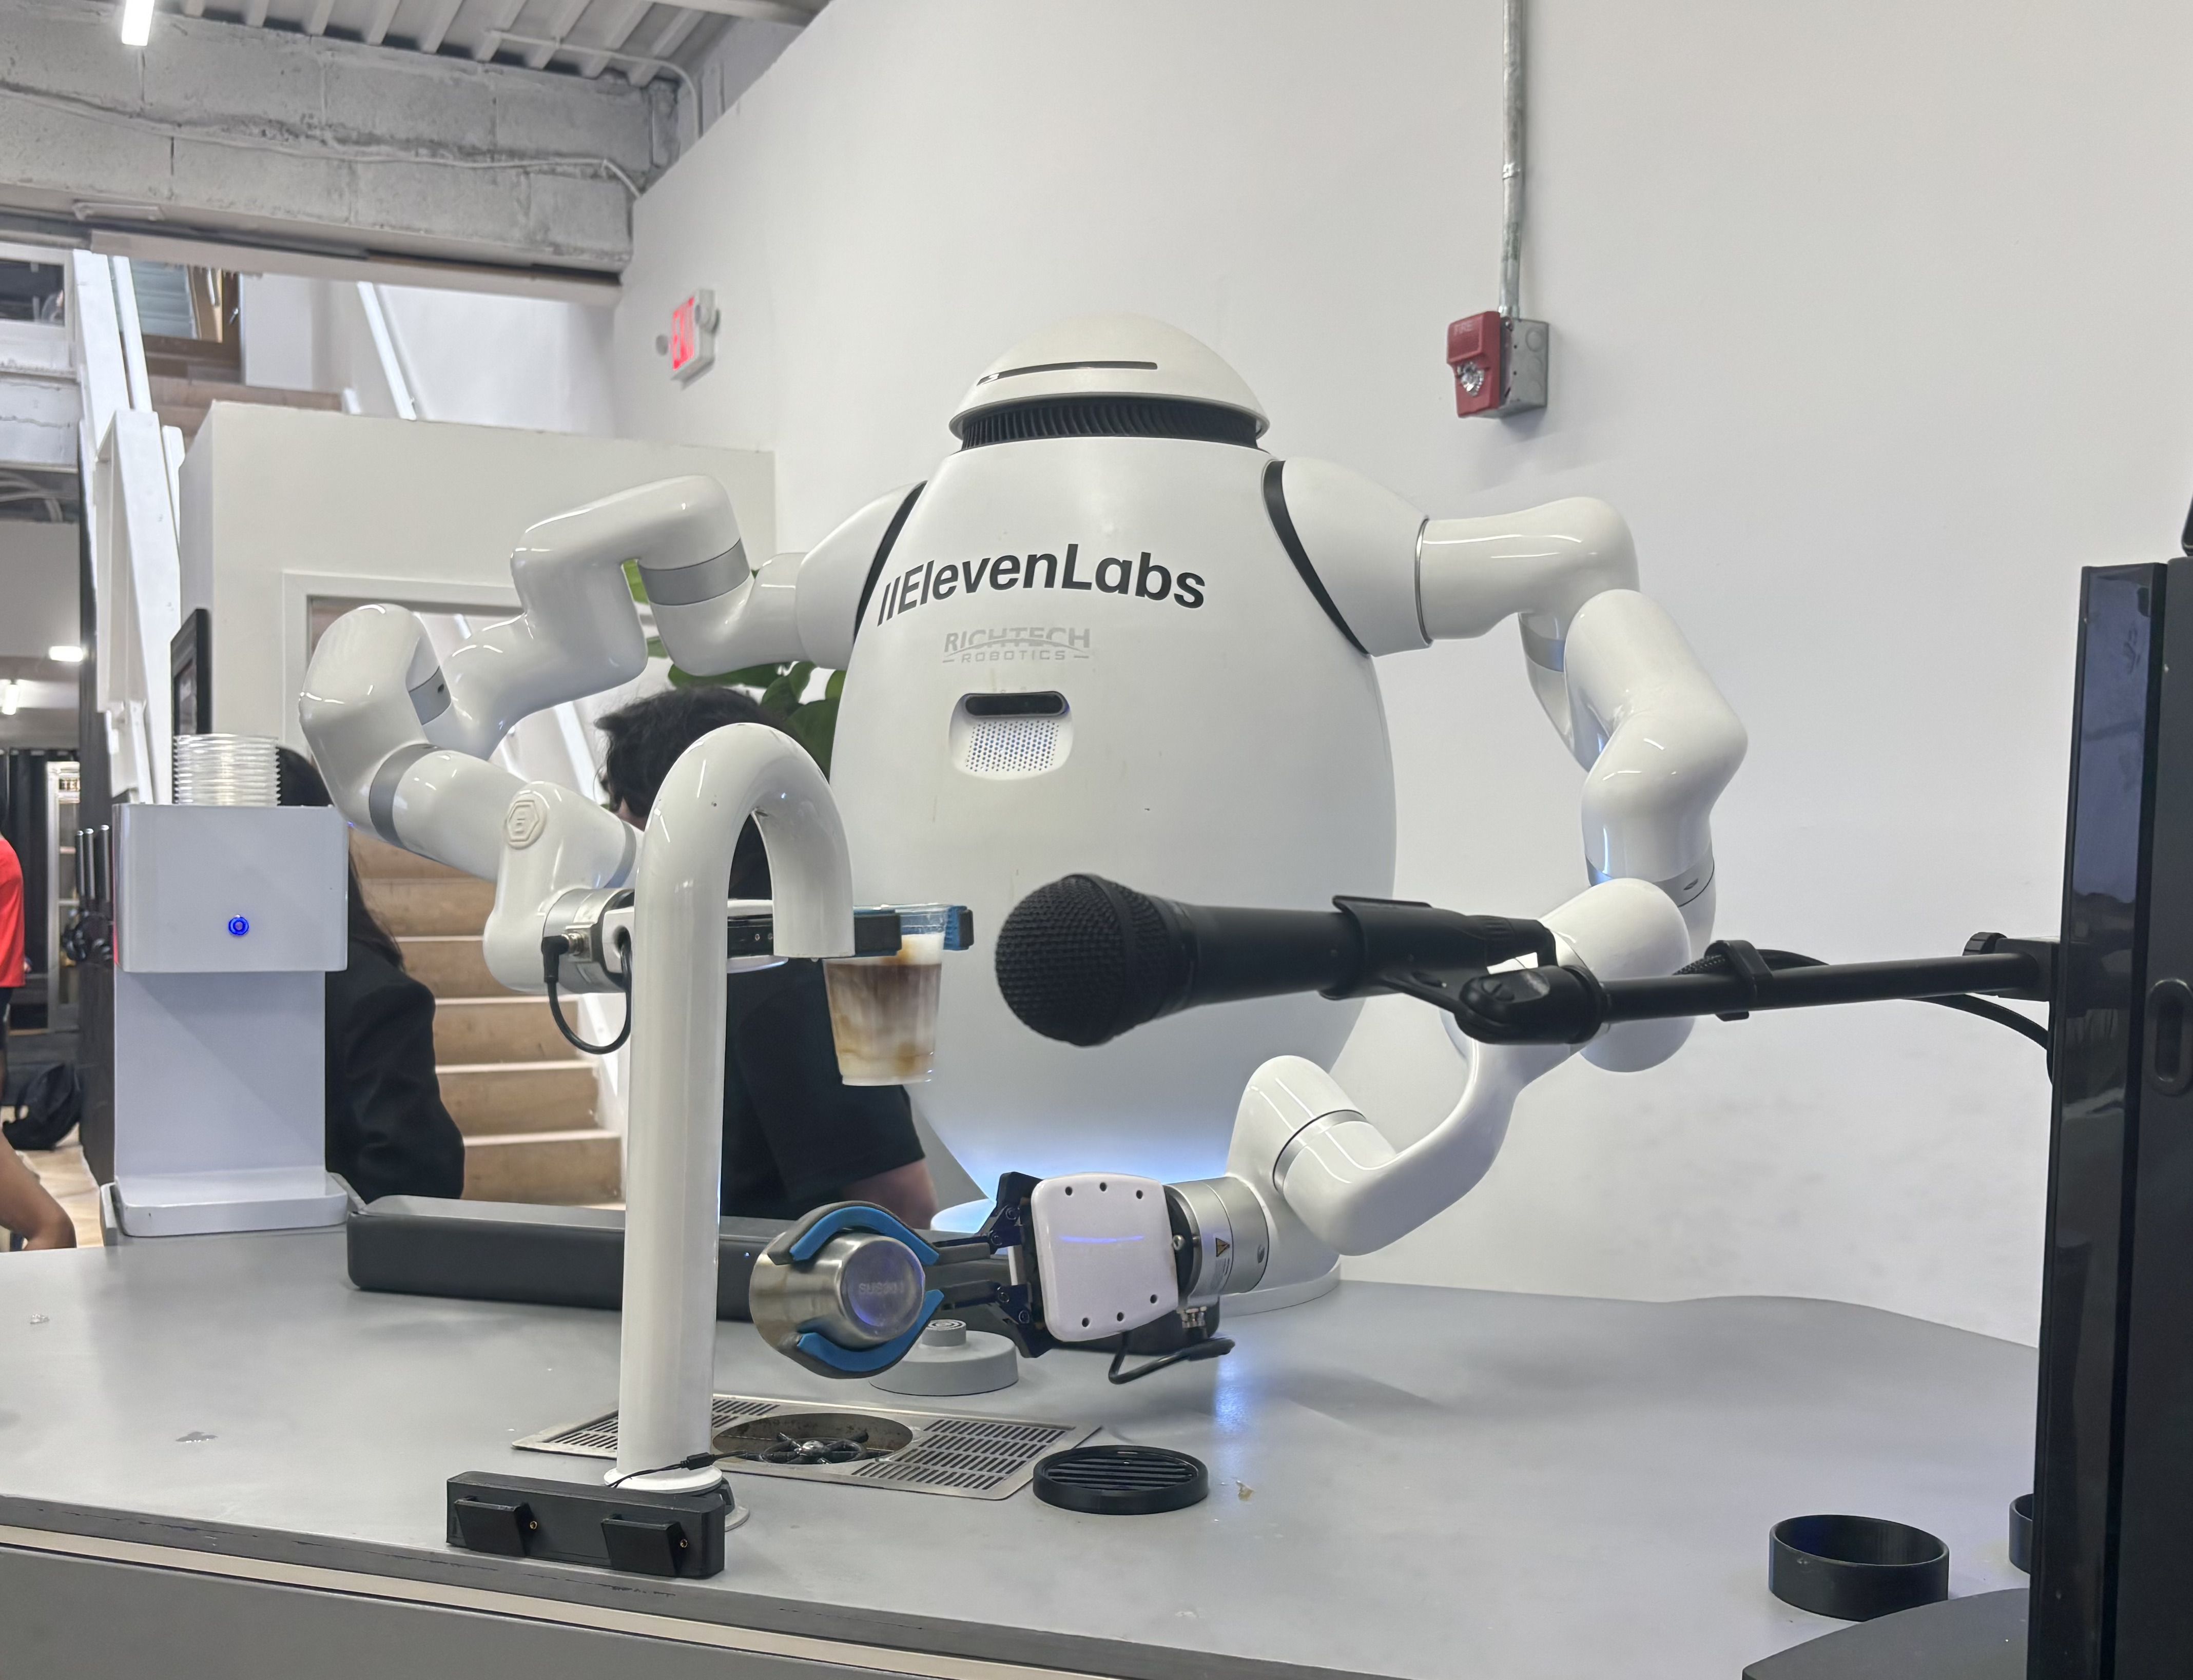
ElevenLabsがニューヨークでポップアップを開催し、同社の音声モデルを搭載したロボットがコーヒー注文を受け付けて飲料を準備するデモを実施
AethexAIは昨年設立され、4DX Venturesが主導する$3 millionのプリシード資金を調達

Suno が $400 million の資金調達を実施し、評価額は $5.4 billion に達した

Snowflakeが四半期で11,100から13,600へAIアカウント数が増加し、製品売上が34%成長、通年ガイダンスを$180 million引き上げたことを受け、SoundHound AI(NASDAQ:SOUN)…

AI音声生成市場は2025年の$4.16 billionから2031年には$20.71 billionに到達する見込み

Sunoのサブレディットで、ユーザーが自分で生成したAI音楽を聴くことに専念し、Spotifyなどの従来のストリーミングプラットフォームでの音楽鑑賞をやめたと述べている

StripeがAI steering実験について開発者向けブログで発表

音声エージェント、ライブキャプショニング、コンタクトセンター分析、アクセシビリティツールは、リアルタイム音声テキスト変換に依存している

Stability AI が Stable Audio 3.0 を発表
ElevenLabsが教授向けの無料アクセスプログラム「Impact Program x Professors」を立ち上げ

Thinking Machines Lab が初のAIモデルを発表

Rivian AssistantがRivian Gen 1およびGen 2の互換車両オーナーに対してソフトウェア更新経由で本日配信開始

リアルタイム音声AIパイプライン向けの軽量性別分類器をリリース

Vapiのエンタープライズ事業は2025年初頭以降10倍成長

Wispr FlowがHinglish(ヒンディー語と英語の混合言語)のロールアウト後、インドでの成長加速を報告

TypeWhisperというMac向けの音声テキスト変換ツールがGitHubで公開された

Dikaletus は TUI ツールで、FFmpeg、PulseAudio、Mistral AI API を用いて会議の音声録音、文字起こし、構造化されたミーティングノート生成を自動化する
OpenAIはRealtime APIで3つの新しいストリーミング音声モデルを提供開始:GPT-Realtime-2(音声対音声推論エージェント向け)、GPT-Realtime-Translate(70以上の入力言語から…
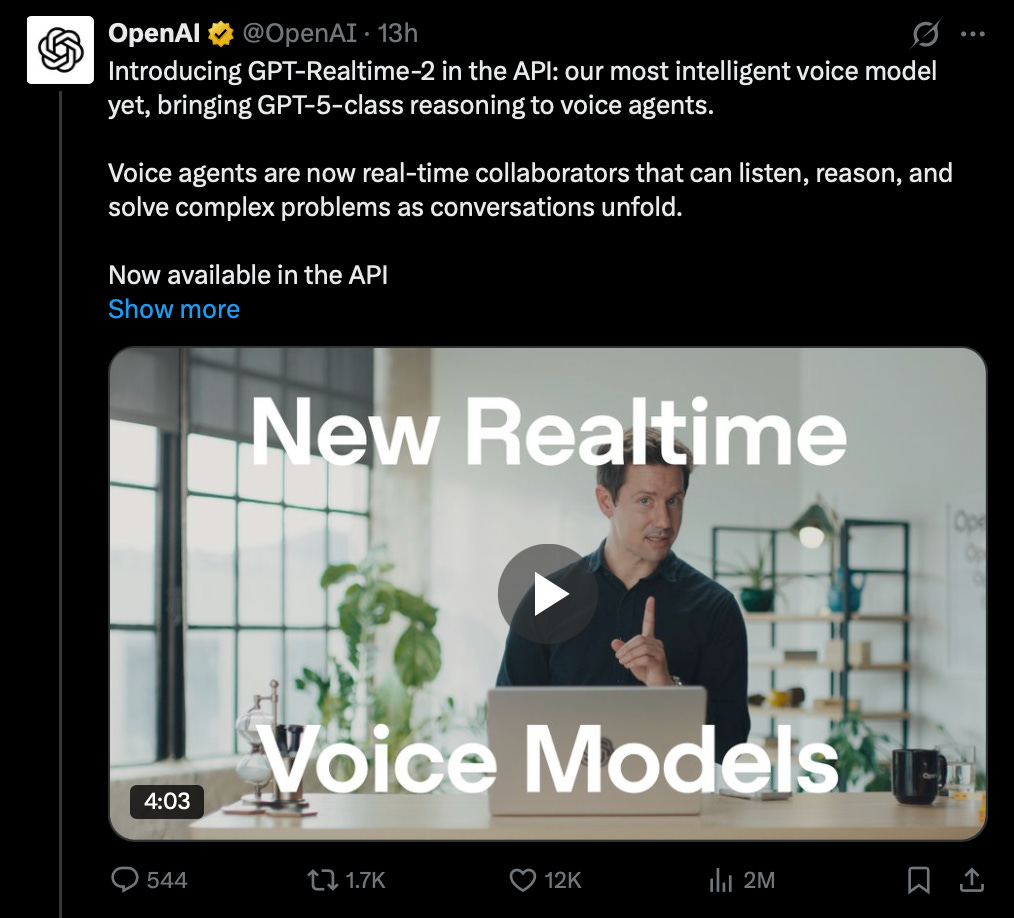
OpenAIがGPT-Realtime-2、GPT-Realtime-Translate、GPT-Realtime-Whisperという3つの新しい音声モデルを提供開始

Googleのスマートホーム向けAI統合が、2025年のAI刷新以来、最大規模のアップデートを受けた

ElevenLabsが新たな投資家としてBlackRock、Jamie Foxx、Eva Longoria を獲得し、年間経常収益(ARR)が$500M に到達した

GitHubで公開されたVoiceGoatは、音声エージェント(ユーザーの音声指示に応じて自分で判断して作業するAI)に対するLLM(大規模言語モデル)攻撃を練習するためのツール

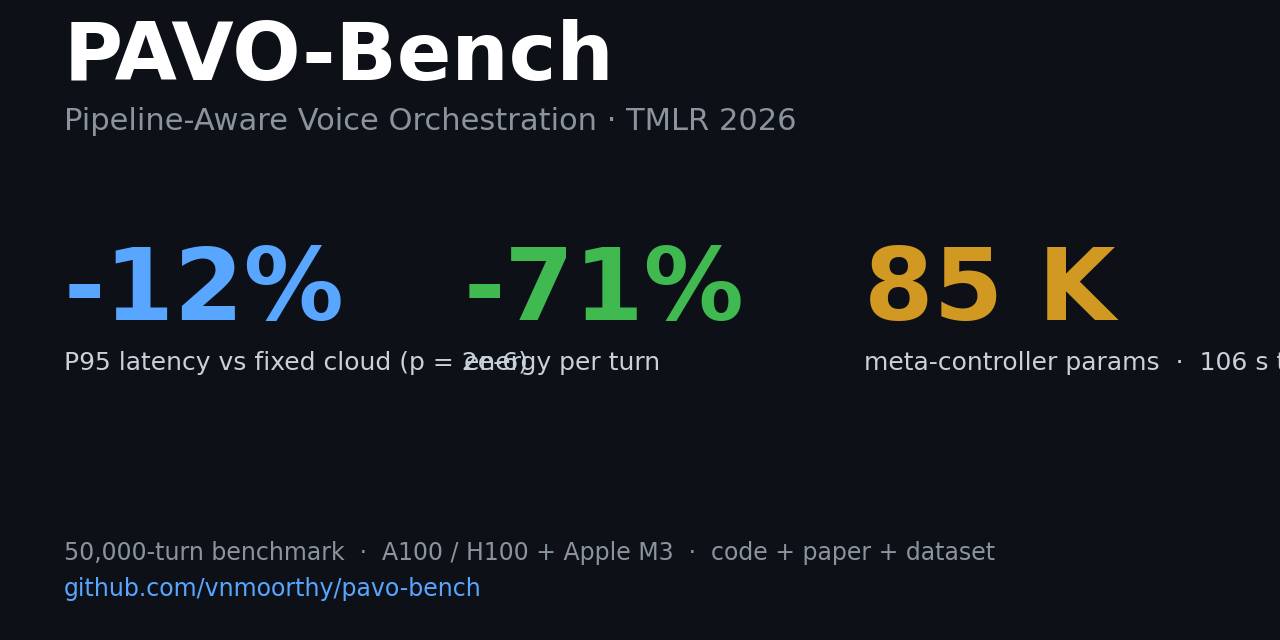
GitHub上で公開されたPAVO-Benchは、音声認識(ASR)からLLM(文章を理解・生成するAI)を経由してテキスト音声変換(TTS)に至る一連の処理を評価するためのベンチマークデータセット
MicrosoftがVibeVoiceという音声AIモデルをGitHubで公開
Ubuntu開発元のCanonicalのエンジニアリング担当VP Jon Seagerが月曜日にブログ投稿を公開し、Linux ディストリビューションへのai機能追加計画を発表した
ComfyUI は AI 画像・動画・音声生成ツールの開発企業で、今回 3000 万ドルの資金調達を実施し、企業価値が 5 億ドルに達した

調査によると、米国の成人の50%以上が過去1週間の間に仕事でAI(ChatGPTなどの文章生成AI)を使用している

TTS.aiは新しいテキスト音声変換プラットフォームとして発表された

transformers.js、Whisper、WebGPUを使用してクライアント側で完全にローカルで動作するAIワークスペースを開発

100以上のソースから厳選したAIニュースを毎日無料でお届けします。
月間読者 60,000+
無料で始める登録無料・Googleアカウントなら30秒・いつでも解除できます